Les quatre premières parties ont présenté les mécanismes de LTN sur des exemples jouets. Cette étude de cas les met à l’épreuve sur un problème plus exigeant : reconnaître des chiffres manuscrits sans jamais voir l’étiquette d’un seul chiffre.
On donne au modèle deux images de chiffres, et une seule information : leur somme. À partir de là, il doit apprendre à reconnaître chaque chiffre. On compare ensuite ce LTN à une baseline purement supervisée, qui apprend à prédire la somme directement, sans aucune connaissance logique.
Pourquoi cet exemple ?
Ce problème n’a pas été choisi au hasard. C’est un cas classique de la littérature neuro-symbolique, introduit par l’article DeepProbLog (Manhaeve et al., 2018) et repris dans l’article original de LTN. Il a trois qualités qui en font un bon terrain de comparaison :
- il isole la difficulté qui nous intéresse. Reconnaître un chiffre manuscrit est une tâche bien maîtrisée par les réseaux de neurones. L’enjeu est ici de combiner plusieurs informations pour produire une réponse, ce qui permet d’observer l’apport de la logique ;
- la règle est connue : la réponse est la somme des chiffres. Mais les deux approches l’utilisent différemment : la baseline doit l’apprendre à partir des exemples, alors que le LTN l’exprime explicitement sous forme de règle logique ;
- la difficulté se règle facilement, en augmentant le nombre de chiffres à combiner. On peut ainsi voir comment les deux approches se comportent quand le problème se complique.
Le problème
On considère deux tâches, construites à partir du jeu de données MNIST de chiffres manuscrits.
L’addition de deux chiffres. Soit le prédicat , où et sont des images de chiffres et un entier égal à leur somme. Il doit estimer la validité de l’addition : est valide, ne l’est pas. Ici, désigne simplement « une image du chiffre », pas une fonction logique.
L’addition de nombres à deux chiffres. Le prédicat devient :
où chaque liste représente un nombre à deux chiffres. La première addition ci-dessous est valide, la seconde ne l’est pas :
L’approche neuro-symbolique consiste à apprendre un classifieur de chiffre unique, et à s’appuyer sur ce qu’on sait déjà de l’addition. Si un prédicat donne la vraisemblance que l’image représente le chiffre , l’addition s’écrit en LTN :
La difficulté est qu’aucune étiquette de chiffre individuel n’est fournie pendant l’entraînement : on ne connaît que la somme de chaque paire. Le classifieur n’est donc jamais entraîné directement sur sa propre tâche. Sa sortie reste une information latente, que seule la logique exploite. Ce n’est pas un problème pour LTN, puisque le gradient se propage à travers toute la structure logique, jusqu’aux poids du classifieur.
La théorie LTN
Domaines :
- : les images de chiffres MNIST ;
- : les entiers qui sont des résultats d’addition ;
- : les chiffres de 0 à 9.
Variables :
- parcourent les images, les résultats et les chiffres ;
- , , .
Prédicat : , le classifieur de chiffre unique, qui renvoie la probabilité que l’image représente le chiffre . Son domaine d’entrée est .
Axiomes. Pour l’addition de deux chiffres :
et pour l’addition de nombres à deux chiffres :
On retrouve deux mécanismes de la partie 2 :
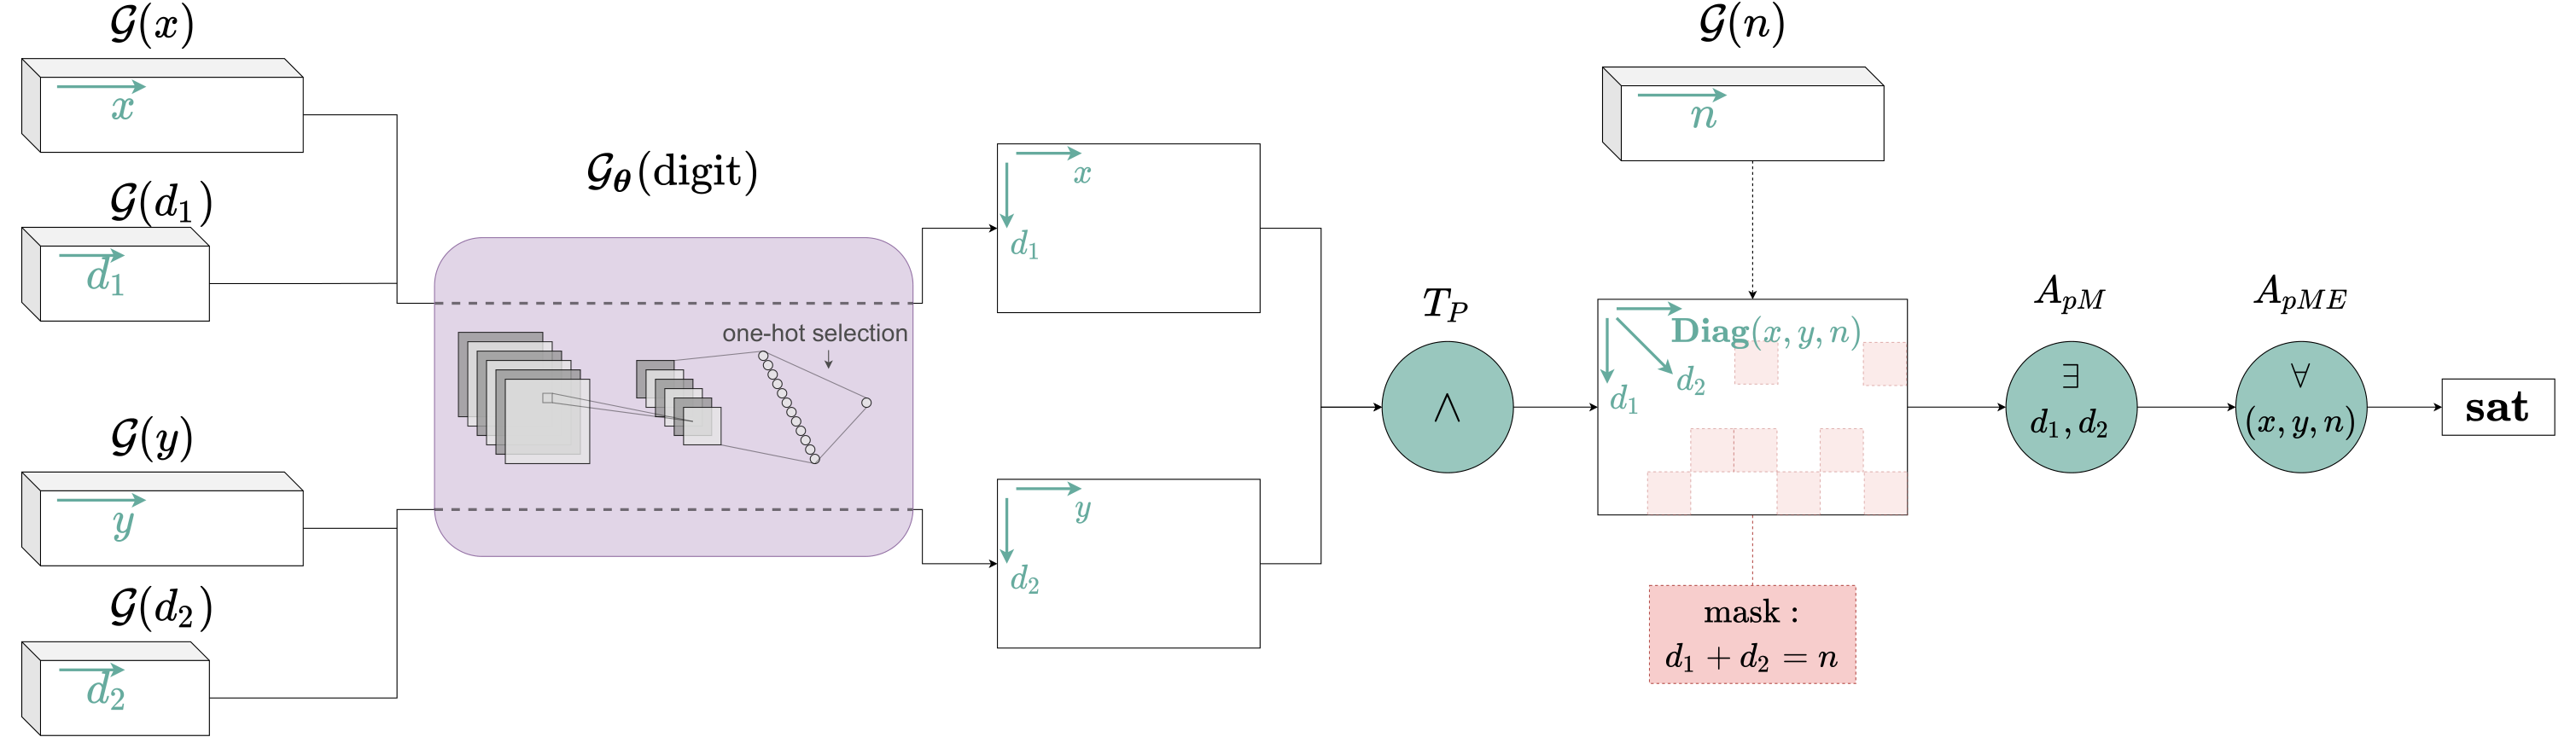
- la quantification diagonale garantit que les -èmes éléments de , et se correspondent : forme un triplet du jeu de données. LTN agrège chaque paire d’images avec son propre résultat, et non avec n’importe quel résultat ;
- la quantification gardée ne retient, parmi les chiffres possibles, que ceux dont la somme peut donner le résultat. C’est par elle que l’information symbolique entre dans le système.
Grounding :
- : les images MNIST font 28 × 28 pixels en niveaux de gris, et leurs valeurs, de 0 à 255 au départ, sont ramenées dans ;
- et ;
- et : les trois variables ont le même nombre d’exemples, puisque les fait correspondre un à un ;
- ;
- , où est un réseau convolutif à 10 sorties, une par chiffre. Contrairement aux parties précédentes, est ici un entier brut, que convertit au moment de l’évaluation.
La figure de l’article original résume le graphe de calcul complet pour l’addition de deux chiffres :
Le jeu de données
MNIST contient 70 000 images : 60 000 pour l’entraînement et 10 000 pour le test. Il faut en tirer un jeu de données d’additions.
- Pour deux chiffres, les 30 000 premières images d’entraînement servent d’opérandes gauches, les 30 000 suivantes d’opérandes droits, et la somme de leurs étiquettes sert de cible. On procède de même pour le test.
- Pour deux nombres à deux chiffres, l’ensemble d’entraînement est découpé en quatre groupes de 15 000 images : les deux premiers forment les chiffres du premier nombre, les deux derniers ceux du second.
import torch
import pandas as pd
import torchvision

def get_mnist_dataset_for_digits_addition(single_digit=True):
    """
    Prépare le jeu de données pour l'exemple d'addition de chiffres MNIST (chiffre simple ou multi-chiffres)
    de l'article LTN.

    :param single_digit: indique si le jeu de données doit être généré pour le cas à un seul chiffre
        ou à plusieurs chiffres (voir la spécification ci-dessus pour comprendre la différence entre les deux).
    :return: un couple de deux éléments. Le premier est l'ensemble d'entraînement, le second l'ensemble de test.
        Chacun est une liste contenant :
        1. une liste [operandes_gauches, operandes_droits], où operandes_gauches est une liste d'images MNIST
           utilisées comme opérande gauche de l'addition, et operandes_droits comme opérande droit ;
        2. une liste contenant la somme des étiquettes des images du point 1. L'étiquette de l'opérande gauche
           est ajoutée à celle de l'opérande droit, formant la cible de la tâche d'addition.
    Ceci décrit le résultat pour le cas à un seul chiffre. Dans le cas multi-chiffres, la liste du point 1
    comportera 4 éléments, puisque quatre chiffres interviennent dans chaque addition (deux pour représenter
    le premier opérande, deux pour le second).
    """
    if single_digit:
        n_train_examples = 30000
        n_test_examples = 5000
        n_operands = 2
    else:
        n_train_examples = 15000
        n_test_examples = 2500
        n_operands = 4

    mnist_train = torchvision.datasets.MNIST("./datasets/", train=True, download=True,
                                             transform=torchvision.transforms.ToTensor())
    mnist_test = torchvision.datasets.MNIST("./datasets/", train=False, download=True,
                                            transform=torchvision.transforms.ToTensor())

    train_imgs, train_labels, test_imgs, test_labels = mnist_train.data, mnist_train.targets, \
                                                       mnist_test.data, mnist_test.targets

    train_imgs, test_imgs = train_imgs / 255.0, test_imgs / 255.0

    train_imgs, test_imgs = torch.unsqueeze(train_imgs, 1), torch.unsqueeze(test_imgs, 1)

    imgs_operand_train = [train_imgs[i * n_train_examples:i * n_train_examples + n_train_examples]
                          for i in range(n_operands)]
    labels_operand_train = [train_labels[i * n_train_examples:i * n_train_examples + n_train_examples]
                            for i in range(n_operands)]

    imgs_operand_test = [test_imgs[i * n_test_examples:i * n_test_examples + n_test_examples]
                         for i in range(n_operands)]
    labels_operand_test = [test_labels[i * n_test_examples:i * n_test_examples + n_test_examples]
                           for i in range(n_operands)]

    if single_digit:
        label_addition_train = labels_operand_train[0] + labels_operand_train[1]
        label_addition_test = labels_operand_test[0] + labels_operand_test[1]
    else:
        label_addition_train = 10 * labels_operand_train[0] + labels_operand_train[1] + \
                               10 * labels_operand_train[2] + labels_operand_train[3]

        label_addition_test = 10 * labels_operand_test[0] + labels_operand_test[1] + \
                              10 * labels_operand_test[2] + labels_operand_test[3]

    train_set = [torch.stack(imgs_operand_train, dim=1), label_addition_train]
    test_set = [torch.stack(imgs_operand_test, dim=1), label_addition_test]

    return train_set, test_set

# jeu de données pour un seul chiffre
single_d_train_set, single_d_test_set = get_mnist_dataset_for_digits_addition(single_digit=True)
# jeu de données pour plusieurs chiffres
multi_d_train_set, multi_d_test_set = get_mnist_dataset_for_digits_addition(single_digit=False)
Comprendre la structure des données
Il faut distinguer trois niveaux : un exemple, le jeu de données et un batch.
Un exemple est une addition. Pour , il contient deux images et un label :
Exemple
├── image du chiffre 3
├── image du chiffre 7
└── label = 10
Chaque image MNIST est un tenseur de forme (1, 28, 28) : un canal (niveaux de gris), 28 pixels de haut, 28 de large. Les deux images d’un exemple sont regroupées dans un tenseur de forme (2, 1, 28, 28).
Le jeu de données regroupe exemples. Les images forment un seul tenseur de forme (m, 2, 1, 28, 28), et les labels un tenseur de forme (m,), avec une correspondance directe : images[i] et labels[i] décrivent la même addition.
(m, 2, 1, 28, 28)
 ↑  ↑
 │  └── nombre d'images par exemple
 └───── nombre d'exemples
C’est exactement ce que contient single_d_train_set : une liste de deux éléments, les images en [0] et les labels en [1]. single_d_train_set[0][0] sélectionne d’abord les images, puis le premier exemple : un tenseur (2, 1, 28, 28). single_d_train_set[1][0] sélectionne le label de ce même exemple, un scalaire.
Un batch regroupe exemples : ses images ont la forme (B, 2, 1, 28, 28) et ses labels (B,). Il ne faut pas confondre les deux premières dimensions : (32, 2, 1, 28, 28) représente 32 additions, chacune décrite par 2 images.
Pour l’addition de nombres à deux chiffres, le principe est identique avec 4 images par exemple : (m, 4, 1, 28, 28) pour le jeu de données, (B, 4, 1, 28, 28) pour un batch.
Affichons le premier exemple d’entraînement pour l’addition de deux chiffres :
import matplotlib.pyplot as plt
first_example_images = single_d_train_set[0][0]
first_example_label = single_d_train_set[1][0]

print("Les opérandes sont affichés dans les images suivantes :")
fig = plt.figure()
ax = fig.add_subplot(1, 2, 1)
imgplot = plt.imshow(first_example_images[0].permute(1, 2, 0))
ax.set_title('Premier opérande')
ax = fig.add_subplot(1, 2, 2)
imgplot = plt.imshow(first_example_images[1].permute(1, 2, 0))
ax.set_title('Second opérande')
plt.show()
print("L'étiquette cible (la somme) pour ces opérandes est : %d" % first_example_label.item())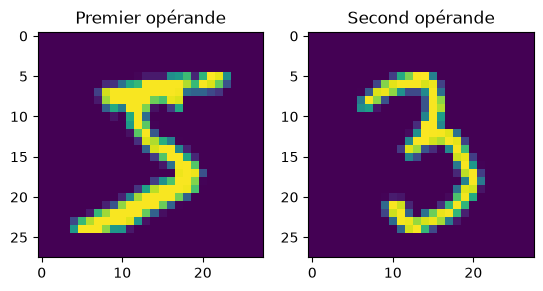
Les opérandes sont affichés dans les images suivantes :
L'étiquette cible (la somme) pour ces opérandes est : 8
Un 5 et un 3, de somme 8 : c’est la seule information que le modèle recevra pour cet exemple.
Le modèle LTN
Il faut définir le prédicat , les variables à , les connecteurs, les quantificateurs et SatAgg. Les connecteurs et les quantificateurs suivent la configuration produit vue dans la partie 3.
Le prédicat repose sur deux modèles :
- le premier est un CNN qui renvoie les logits des dix classes pour une image ;
- le second prend un couple , calcule les logits avec le premier, applique un softmax, et renvoie la probabilité de la classe : la vraisemblance que l’image représente le chiffre .
On garde les deux séparés parce qu’on a besoin des deux sorties : les logits servent à mesurer la précision de classification, et les probabilités sont interprétées comme des degrés de vérité pour calculer la satisfaction de la base de connaissances.
Les variables à parcourent les dix chiffres, . Contrairement aux labels one-hot des parties précédentes, ce sont ici des indices entiers bruts : torch.gather sélectionne directement la probabilité de l’indice .
from torch.nn.init import xavier_uniform_, normal_, kaiming_uniform_
import ltn

# on définit les variables
d_1 = ltn.Variable("d_1", torch.tensor(range(10)))
d_2 = ltn.Variable("d_2", torch.tensor(range(10)))
# utilisées seulement dans le cas multi-chiffres
d_3 = ltn.Variable("d_3", torch.tensor(range(10)))
d_4 = ltn.Variable("d_4", torch.tensor(range(10)))

# on définit le prédicat digit
class MNISTConv(torch.nn.Module):
    """
    CNN qui renvoie des embeddings pour des images MNIST.
    Arguments :
        conv_channels_sizes : tuple contenant le nombre de canaux des couches convolutives du modèle. Le premier
        élément doit être le nombre de canaux d'entrée de la première couche, le dernier le nombre de canaux
        de sortie de la dernière couche. Le nombre de couches construites vaut `len(conv_channels_sizes) - 1` ;

        kernel_sizes : tuple contenant les tailles des noyaux utilisés dans les couches convolutives ;

        linear_layers_sizes : tuple contenant les tailles des couches denses finales de l'architecture. Le premier
        élément doit être le nombre de features en entrée de la première couche dense, le dernier le nombre de
        features en sortie de la dernière. Le nombre de couches construites vaut `len(linear_layers_sizes) - 1`.
    """
    def __init__(self, conv_channels_sizes=(1, 6, 16), kernel_sizes=(5, 5), linear_layers_sizes=(256, 100)):
        super(MNISTConv, self).__init__()
        self.conv_layers = torch.nn.ModuleList([torch.nn.Conv2d(conv_channels_sizes[i - 1], conv_channels_sizes[i],
                                                                kernel_sizes[i - 1])
                                                  for i in range(1, len(conv_channels_sizes))])
        self.elu = torch.nn.ELU()  # activation utilisée partout, comme dans baselines.py (Keras, activation="elu")
        self.maxpool = torch.nn.MaxPool2d((2, 2))
        self.linear_layers = torch.nn.ModuleList([torch.nn.Linear(linear_layers_sizes[i - 1], linear_layers_sizes[i])
                                                  for i in range(1, len(linear_layers_sizes))])

        self.init_weights()

    def forward(self, x):
        for conv in self.conv_layers:
            x = self.elu(conv(x))
            x = self.maxpool(x)
        x = torch.flatten(x, start_dim=1)
        for linear in self.linear_layers:
            x = self.elu(linear(x))
        return x

    def init_weights(self):
        r"""Initialise les poids du réseau.
        Tous les poids (convolutifs et denses) sont initialisés avec :py:func:`torch.nn.init.xavier_uniform_`
        (équivalent de l'initialiseur "glorot_uniform" par défaut de Keras, utilisé dans baselines.py),
        les biais avec :py:func:`torch.nn.init.zeros_`.
        """
        for layer in self.conv_layers:
            xavier_uniform_(layer.weight)
            torch.nn.init.zeros_(layer.bias)

        for layer in self.linear_layers:
            xavier_uniform_(layer.weight)
            torch.nn.init.zeros_(layer.bias)


class SingleDigitClassifier(torch.nn.Module):
    """
    Modèle classifiant une image MNIST de chiffre parmi 10 classes possibles. Il renvoie les logits, une sortie
    non normalisée. Architecture fidèle à baselines.SingleDigit : partie convolutive (MNISTConv, ELU), puis une
    couche dense cachée (ELU), puis la couche de classification finale
    Arguments :
        layers_sizes : tuple contenant les tailles des couches denses finales de l'architecture. Le premier
        élément doit être le nombre de features en entrée de la première couche, le dernier le nombre de
        features en sortie de la dernière. Le nombre de couches construites vaut `len(layers_sizes) - 1`.
    """
    def __init__(self, layers_sizes=(100, 84, 10)):
        super(SingleDigitClassifier, self).__init__()
        self.mnistconv = MNISTConv()  # partie convolutive de l'architecture
        self.elu = torch.nn.ELU()  # activation des couches denses cachées
        self.linear_layers = torch.nn.ModuleList([torch.nn.Linear(layers_sizes[i - 1], layers_sizes[i])
                                                  for i in range(1, len(layers_sizes))])
        self.init_weights()

    def forward(self, x):
        x = self.mnistconv(x)
        for i in range(len(self.linear_layers) - 1):
            x = self.elu(self.linear_layers[i](x))
        return self.linear_layers[-1](x)  # une sigmoïde ou un softmax doit être appliqué sur la dernière couche

    def init_weights(self):
        """Initialise les poids des couches denses du réseau.
        Les poids sont initialisés avec :py:func:`torch.nn.init.xavier_uniform_`,
        les biais avec :py:func:`torch.nn.init.zeros_`.
        """
        for layer in self.linear_layers:
            xavier_uniform_(layer.weight)
            torch.nn.init.zeros_(layer.bias)


class LogitsToPredicate(torch.nn.Module):
    """
    Ce modèle encapsule un modèle de logits, qui calcule les logits des classes pour une image x donnée en entrée.
    L'idée est de garder logits et probabilités séparés : le modèle de logits renvoie les logits pour un exemple,
    tandis que ce modèle-ci renvoie les probabilités à partir de ces logits.

    Concrètement, il prend en entrée une image x et une étiquette de classe d. Il applique le modèle de logits
    à x pour obtenir les logits, puis une fonction softmax pour obtenir les probabilités par classe. Enfin, il
    ne renvoie que la probabilité associée à la classe d, sélectionnée directement par indexation plutôt que
    par produit avec un vecteur one-hot, puisque d est ici un indice entier brut.
    """
    def __init__(self, logits_model):
        super(LogitsToPredicate, self).__init__()
        self.logits_model = logits_model
        self.softmax = torch.nn.Softmax(dim=1)

    def forward(self, x, d):
        logits = self.logits_model(x)
        probs = self.softmax(logits)
        out = torch.gather(probs, 1, d)
        return out

# chiffre simple
cnn_s_d = SingleDigitClassifier()
Digit_s_d = ltn.Predicate(LogitsToPredicate(cnn_s_d)).to(ltn.device)
# chiffres multiples
cnn_m_d = SingleDigitClassifier()
Digit_m_d = ltn.Predicate(LogitsToPredicate(cnn_m_d)).to(ltn.device)

# on définit les connecteurs, quantificateurs, et SatAgg
And = ltn.Connective(ltn.fuzzy_ops.AndProd())
Exists = ltn.Quantifier(ltn.fuzzy_ops.AggregPMean(p=2), quantifier="e")
Forall = ltn.Quantifier(ltn.fuzzy_ops.AggregPMeanError(p=2), quantifier="f")
SatAgg = ltn.fuzzy_ops.SatAgg()
La baseline
Pour comparer, on entraîne aussi un réseau classique, sans logique. Il encode chaque image avec le même tronc convolutif que le LTN (poids partagés entre les opérandes), concatène les représentations, puis prédit directement la somme. C’est une classification à 19 classes pour deux chiffres (de 0 à 18), et à 199 classes pour deux nombres à deux chiffres (de 0 à 198).
# ===============================================
# BASELINE (CNN classique, sans logique)
# ===============================================

class BaselineNet(torch.nn.Module):
    """
    Réseau "baseline" : encode chaque image opérande avec le MÊME tronc convolutif
    (MNISTConv, poids partagés, architecture siamoise), concatène les embeddings, puis une
    couche dense cachée (ELU) et une couche de classification finale (logits bruts) prédisent
    directement la classe du résultat (la somme) — sans prédicats logiques intermédiaires.
    """
    def __init__(self, n_operands, n_classes, embedding_dim=100, hidden_dim=100):
        super(BaselineNet, self).__init__()
        self.encoder = MNISTConv()  # tronc convolutif partagé entre les opérandes
        self.fc1 = torch.nn.Linear(embedding_dim * n_operands, hidden_dim)
        self.fc2 = torch.nn.Linear(hidden_dim, n_classes)
        self.elu = torch.nn.ELU()
        self.init_weights()

    def init_weights(self):
        xavier_uniform_(self.fc1.weight)
        torch.nn.init.zeros_(self.fc1.bias)
        xavier_uniform_(self.fc2.weight)
        torch.nn.init.zeros_(self.fc2.bias)

    def forward(self, images_list):
        embeddings = [self.encoder(img) for img in images_list]
        x = torch.cat(embeddings, dim=1)
        x = self.elu(self.fc1(x))
        return self.fc2(x)  # logits bruts


# baseline pour le cas à un seul chiffre : somme de 2 chiffres -> 19 classes (0 à 18)
baseline_s_d = BaselineNet(n_operands=2, n_classes=19, hidden_dim=84).to(ltn.device)
# baseline pour le cas multi-chiffres : somme de deux nombres à 2 chiffres -> 199 classes (0 à 198)
baseline_m_d = BaselineNet(n_operands=4, n_classes=199, hidden_dim=128).to(ltn.device)
On définit enfin un chargeur de données, pour l’entraînement et le test des deux tâches :
import numpy as np

# chargeur de données PyTorch standard, pour l'entraînement et le test du modèle
class DataLoader(object):
    def __init__(self,
                 fold,
                 batch_size=1,
                 shuffle=True):
        self.fold = fold
        self.batch_size = batch_size
        self.shuffle = shuffle

    def __len__(self):
        return int(np.ceil(self.fold[0].shape[0] / self.batch_size))

    def __iter__(self):
        n = self.fold[0].shape[0]
        idxlist = list(range(n))
        if self.shuffle:
            np.random.shuffle(idxlist)

        for _, start_idx in enumerate(range(0, n, self.batch_size)):
            end_idx = min(start_idx + self.batch_size, n)
            digits = self.fold[0][idxlist[start_idx:end_idx]]
            addition_labels = self.fold[1][idxlist[start_idx:end_idx]]

            yield digits, addition_labels

# création des chargeurs d'entraînement et de test
single_train_loader = DataLoader(single_d_train_set, 32, shuffle=True)
single_test_loader = DataLoader(single_d_test_set, 32, shuffle=False)
multi_d_train_loader = DataLoader(multi_d_train_set, 32, shuffle=True)
multi_d_test_loader = DataLoader(multi_d_test_set, 32, shuffle=False)
Les deux approches partagent donc tout, sauf la façon d’apprendre :
| LTN | Baseline | |
|---|---|---|
| Données d’entrée | identiques | identiques |
| Tronc convolutif | architecture identique | architecture identique |
| Taille de batch | 32 | 32 |
| Optimiseur | Adam, | Adam, |
| Objectif | maximiser la satisfaction | minimiser l’erreur sur la somme |
| Fonction de perte | entropie croisée | |
| Connaissance logique | aucune | |
| Epochs | 20 | 30 |
La baseline est entraînée plus longtemps (30 epochs contre 20), comme dans le protocole de l’article.
L’apprentissage
Notons l’ensemble des exemples. L’objectif est :
c’est-à-dire que chaque formule de est évaluée sur les exemples de avec le modèle de paramètres , puis que agrège ces satisfactions. En pratique, l’optimiseur minimise, sur un mini-batch tiré de :
Comme la base de connaissances ne contient ici qu’un seul axiome, SatAgg n’est pas utilisé explicitement : appliqué à une seule valeur, il la renverrait inchangée. Le résultat de Forall sert directement de niveau de satisfaction.
Le planning de . Le paramètre du quantificateur existentiel augmente par paliers pendant l’entraînement : , puis 2, puis 4, puis 6. Au début, le classifieur est proche du hasard. Un élevé concentrerait tout le gradient sur la meilleure hypothèse du moment, et risquerait de renforcer une mauvaise combinaison de chiffres simplement parce qu’elle a la plus haute confiance à l’initialisation. Un faible répartit le gradient sur toutes les combinaisons plausibles et laisse le bon signal émerger ; on resserre ensuite le focus quand le classifieur devient fiable. C’est l’application directe du compromis vu dans la partie 3.
La précision est mesurée en prédisant chaque chiffre avec le CNN, puis en vérifiant que l’addition reconstituée donne le bon résultat.
Voici le cœur de l’entraînement, la formule évaluée à chaque batch :
sat_agg = Forall(
    ltn.diag(images_x, images_y, labels_z),
    Exists(
        [d_1, d_2],
        And(Digit_s_d(images_x, d_1), Digit_s_d(images_y, d_2)),
        cond_vars=[d_1, d_2, labels_z],
        cond_fn=lambda d1, d2, z: torch.eq(d1.value + d2.value, z.value),
        p=p
    )).value
Elle se lit : pour chaque exemple, il doit exister deux chiffres qui correspondent aux deux images et dont la somme est égale au résultat observé.
Comment cette formule apprend les chiffres, étape par étape
Prenons un batch de deux exemples : et .
1. Les données. Les premières images vont dans images_x, les secondes dans images_y, les résultats dans labels_z, chacun avec une dimension de batch de 2. ltn.diag(images_x, images_y, labels_z) garde les triplets alignés : (image de 2, image de 3, 5) et (image de 1, image de 4, 5), sans croiser les images d’un exemple avec le résultat d’un autre.
2. Le prédicat Digit. Pour une image, le CNN produit des logits, puis un softmax donne une distribution sur les dix chiffres, par exemple :
d      0     1     2     3     4     5   ...
p_d   0.01  0.02  0.90  0.01  0.01  0.01 ...
Digit_s_d(x, d) vaut la probabilité du chiffre : ici , une forte valeur de vérité pour « l’image représente un 2 ».
3. Les couples admissibles. et parcourent chacun , soit 100 couples possibles. Le masque cond_fn ne garde que ceux dont la somme vaut le résultat. Pour : . Ce masque ne reconnaît rien dans les pixels : il dit seulement quelles combinaisons de chiffres sont compatibles avec le label.
4. La conjonction. Pour chaque couple admissible, And multiplie les deux probabilités. Supposons que le réseau donne 0.90 au 2 pour la première image et 0.85 au 3 pour la seconde :
AndProd | |||
|---|---|---|---|
| (0, 5) | 0.01 | 0.02 | 0.0002 |
| (1, 4) | 0.02 | 0.01 | 0.0002 |
| (2, 3) | 0.90 | 0.85 | 0.7650 |
| (3, 2) | 0.01 | 0.03 | 0.0003 |
| (4, 1) | 0.01 | 0.02 | 0.0002 |
| (5, 0) | 0.01 | 0.01 | 0.0001 |
Plusieurs couples sont mathématiquement corrects, et la contrainte seule ne suffit pas à trancher. C’est le prédicat Digit qui apporte l’information visuelle : la logique dit , et le CNN dit quelles valeurs sont les plus plausibles d’après les images.
5. L’existentiel. Exists agrège les six valeurs avec pMean : pour , . Le résultat est d’autant plus élevé qu’au moins une explication est très plausible, ici le couple (2, 3).
6. L’universel. Exists produit une satisfaction par exemple, puis Forall les agrège avec pMeanError en une satisfaction globale pour le batch. Un exemple très mal expliqué pèse plus lourd qu’un exemple déjà bien satisfait.
7. Le gradient. Toute cette chaîne est différentiable : poids du CNN → logits → softmax → Digit → And → Exists → Forall. Le gradient remonte en sens inverse. Pour le couple (2, 3), la satisfaction vaut , avec et , donc et : le gradient agit sur les probabilités, puis sur les logits, puis sur les poids du CNN.
8. Pourquoi les chiffres finissent par être appris. Un exemple isolé comme ne suffit pas à identifier les deux chiffres. L’information vient de l’ensemble des exemples : un 2 apparaît aussi dans , , … L’hypothèse « c’est un 2 » reste cohérente avec toutes ces additions, alors qu’une hypothèse fausse devient incompatible avec un nombre croissant d’exemples. Comme le même CNN est partagé par tous les exemples, les gradients de toutes ces contraintes s’accumulent, et le poussent vers des distributions où pour les images de 2. Les chiffres individuels jouent le rôle de variables latentes : le CNN fournit les prédictions, la logique fournit les contraintes.
Addition de deux chiffres
On entraîne le LTN pendant 20 epochs :
history_single = {"train_loss": [], "train_sat": [], "train_acc": [],
                   "test_loss": [], "test_sat": [], "test_acc": []}

optimizer = torch.optim.Adam(Digit_s_d.parameters(), lr=0.001)

for epoch in range(20):
    # planification du paramètre p pour le quantificateur existentiel, comme décrit dans l'article LTN
    if epoch in range(0, 4):
        p = 1
    if epoch in range(4, 8):
        p = 2
    if epoch in range(8, 12):
        p = 4
    if epoch in range(12, 20):
        p = 6
    train_loss, test_loss = 0.0, 0.0
    train_sat, test_sat = 0.0, 0.0
    train_acc, test_acc = 0.0, 0.0
    # étape d'entraînement
    cnn_s_d.train()
    for batch_idx, (operand_images, addition_label) in enumerate(single_train_loader):
        optimizer.zero_grad()
        # on groundes les variables avec les données du batch courant
        images_x = ltn.Variable("x", operand_images[:, 0])
        images_y = ltn.Variable("y", operand_images[:, 1])
        labels_z = ltn.Variable("z", addition_label)
        sat_agg = Forall(
            ltn.diag(images_x, images_y, labels_z),
            Exists(
                [d_1, d_2],
                And(Digit_s_d(images_x, d_1), Digit_s_d(images_y, d_2)),
                cond_vars=[d_1, d_2, labels_z],
                cond_fn=lambda d1, d2, z: torch.eq(d1.value + d2.value, z.value),
                p=p
            )).value
        loss = 1. - sat_agg
        loss.backward()
        optimizer.step()
        train_loss += loss.item()
        train_sat += sat_agg.item()
        # calcul de la précision d'entraînement
        predictions_x = torch.argmax(cnn_s_d(operand_images[:, 0].to(ltn.device)), dim=1)
        predictions_y = torch.argmax(cnn_s_d(operand_images[:, 1].to(ltn.device)), dim=1)
        predictions = predictions_x + predictions_y
        train_acc += torch.count_nonzero(torch.eq(addition_label.to(ltn.device), predictions)) / predictions.shape[0]
    train_loss = train_loss / len(single_train_loader)
    train_sat = train_sat / len(single_train_loader)
    train_acc = train_acc / len(single_train_loader)

    # étape de test
    cnn_s_d.eval()
    with torch.no_grad():
        for batch_idx, (operand_images, addition_label) in enumerate(single_test_loader):
            # on groundes les variables avec les données du batch courant
            images_x = ltn.Variable("x", operand_images[:, 0])
            images_y = ltn.Variable("y", operand_images[:, 1])
            labels_z = ltn.Variable("z", addition_label)
            sat_agg = Forall(
                ltn.diag(images_x, images_y, labels_z),
                Exists(
                    [d_1, d_2],
                    And(Digit_s_d(images_x, d_1), Digit_s_d(images_y, d_2)),
                    cond_vars=[d_1, d_2, labels_z],
                    cond_fn=lambda d1, d2, z: torch.eq(d1.value + d2.value, z.value),
                    p=p
                )).value
            loss = 1. - sat_agg
            test_loss += loss.item()
            test_sat += sat_agg.item()
            # calcul de la précision de test
            predictions_x = torch.argmax(cnn_s_d(operand_images[:, 0].to(ltn.device)), dim=1)
            predictions_y = torch.argmax(cnn_s_d(operand_images[:, 1].to(ltn.device)), dim=1)
            predictions = predictions_x + predictions_y
            test_acc += torch.count_nonzero(torch.eq(addition_label.to(ltn.device), predictions)) / predictions.shape[0]
    test_loss = test_loss / len(single_test_loader)
    test_sat = test_sat / len(single_test_loader)
    test_acc = test_acc / len(single_test_loader)

    # enregistrement de l'historique
    history_single["train_loss"].append(float(train_loss))
    history_single["train_sat"].append(float(train_sat))
    history_single["train_acc"].append(float(train_acc))
    history_single["test_loss"].append(float(test_loss))
    history_single["test_sat"].append(float(test_sat))
    history_single["test_acc"].append(float(test_acc))

    # affichage des métriques à chaque epoch
    print(" epoch %d | Train loss %.4f | Train Sat %.4f | Train Acc %.4f | Test loss %.4f | Test Sat %.4f |"
                " Test Acc %.4f " %
          (epoch, train_loss, train_sat, train_acc, test_loss, test_sat, test_acc))
epoch 0 | Train loss 0.8594 | Train Sat 0.1406 | Train Acc 0.8124 | Test loss 0.8325 | Test Sat 0.1675 | Test Acc 0.9357
epoch 1 | Train loss 0.8349 | Train Sat 0.1651 | Train Acc 0.9415 | Test loss 0.8293 | Test Sat 0.1707 | Test Acc 0.9496
epoch 2 | Train loss 0.8313 | Train Sat 0.1687 | Train Acc 0.9568 | Test loss 0.8282 | Test Sat 0.1718 | Test Acc 0.9554
epoch 3 | Train loss 0.8298 | Train Sat 0.1702 | Train Acc 0.9624 | Test loss 0.8275 | Test Sat 0.1725 | Test Acc 0.9616
epoch 4 | Train loss 0.6184 | Train Sat 0.3816 | Train Acc 0.9614 | Test loss 0.6125 | Test Sat 0.3875 | Test Acc 0.9630
epoch 5 | Train loss 0.6125 | Train Sat 0.3875 | Train Acc 0.9699 | Test loss 0.6102 | Test Sat 0.3898 | Test Acc 0.9662
epoch 6 | Train loss 0.6090 | Train Sat 0.3910 | Train Acc 0.9751 | Test loss 0.6097 | Test Sat 0.3903 | Test Acc 0.9668
epoch 7 | Train loss 0.6085 | Train Sat 0.3915 | Train Acc 0.9761 | Test loss 0.6068 | Test Sat 0.3932 | Test Acc 0.9739
epoch 8 | Train loss 0.4046 | Train Sat 0.5954 | Train Acc 0.9711 | Test loss 0.3988 | Test Sat 0.6012 | Test Acc 0.9703
epoch 9 | Train loss 0.3984 | Train Sat 0.6016 | Train Acc 0.9756 | Test loss 0.3984 | Test Sat 0.6016 | Test Acc 0.9703
epoch 10 | Train loss 0.3970 | Train Sat 0.6030 | Train Acc 0.9765 | Test loss 0.4024 | Test Sat 0.5976 | Test Acc 0.9668
epoch 11 | Train loss 0.3956 | Train Sat 0.6044 | Train Acc 0.9774 | Test loss 0.3956 | Test Sat 0.6044 | Test Acc 0.9731
epoch 12 | Train loss 0.3032 | Train Sat 0.6968 | Train Acc 0.9782 | Test loss 0.3022 | Test Sat 0.6978 | Test Acc 0.9749
epoch 13 | Train loss 0.3030 | Train Sat 0.6970 | Train Acc 0.9777 | Test loss 0.3082 | Test Sat 0.6918 | Test Acc 0.9707
epoch 14 | Train loss 0.3016 | Train Sat 0.6984 | Train Acc 0.9789 | Test loss 0.3093 | Test Sat 0.6907 | Test Acc 0.9691
epoch 15 | Train loss 0.2990 | Train Sat 0.7010 | Train Acc 0.9799 | Test loss 0.2994 | Test Sat 0.7006 | Test Acc 0.9765
epoch 16 | Train loss 0.2984 | Train Sat 0.7016 | Train Acc 0.9806 | Test loss 0.3218 | Test Sat 0.6782 | Test Acc 0.9598
epoch 17 | Train loss 0.2977 | Train Sat 0.7023 | Train Acc 0.9807 | Test loss 0.3004 | Test Sat 0.6996 | Test Acc 0.9755
epoch 18 | Train loss 0.2982 | Train Sat 0.7018 | Train Acc 0.9807 | Test loss 0.3043 | Test Sat 0.6957 | Test Acc 0.9723
epoch 19 | Train loss 0.2961 | Train Sat 0.7039 | Train Acc 0.9818 | Test loss 0.3090 | Test Sat 0.6910 | Test Acc 0.9701Puis la baseline, pendant 30 epochs :
history_baseline_single = {"train_loss": [], "train_acc": [], "test_loss": [], "test_acc": []}

optimizer_baseline_s = torch.optim.Adam(baseline_s_d.parameters(), lr=0.001)
criterion = torch.nn.CrossEntropyLoss()

for epoch in range(30):
    train_loss, train_acc = 0.0, 0.0
    # étape d'entraînement
    baseline_s_d.train()
    for batch_idx, (operand_images, addition_label) in enumerate(single_train_loader):
        images_x = operand_images[:, 0].to(ltn.device)
        images_y = operand_images[:, 1].to(ltn.device)
        labels = addition_label.to(ltn.device).long()

        optimizer_baseline_s.zero_grad()
        logits = baseline_s_d([images_x, images_y])
        loss = criterion(logits, labels)
        loss.backward()
        optimizer_baseline_s.step()

        train_loss += loss.item()
        predictions = torch.argmax(logits, dim=1)
        train_acc += torch.count_nonzero(torch.eq(labels, predictions)) / predictions.shape[0]
    train_loss = train_loss / len(single_train_loader)
    train_acc = train_acc / len(single_train_loader)

    # étape de test
    test_loss, test_acc = 0.0, 0.0
    baseline_s_d.eval()
    with torch.no_grad():
        for batch_idx, (operand_images, addition_label) in enumerate(single_test_loader):
            images_x = operand_images[:, 0].to(ltn.device)
            images_y = operand_images[:, 1].to(ltn.device)
            labels = addition_label.to(ltn.device).long()

            logits = baseline_s_d([images_x, images_y])
            loss = criterion(logits, labels)

            test_loss += loss.item()
            predictions = torch.argmax(logits, dim=1)
            test_acc += torch.count_nonzero(torch.eq(labels, predictions)) / predictions.shape[0]
    test_loss = test_loss / len(single_test_loader)
    test_acc = test_acc / len(single_test_loader)

    history_baseline_single["train_loss"].append(float(train_loss))
    history_baseline_single["train_acc"].append(float(train_acc))
    history_baseline_single["test_loss"].append(float(test_loss))
    history_baseline_single["test_acc"].append(float(test_acc))

    print(" epoch %d | [Baseline] Train loss %.4f | Train Acc %.4f | Test loss %.4f | Test Acc %.4f " %
          (epoch, train_loss, train_acc, test_loss, test_acc))
epoch 0 | [Baseline] Train loss 1.6665 | Train Acc 0.4358 | Test loss 0.5332 | Test Acc 0.8404
epoch 1 | [Baseline] Train loss 0.3587 | Train Acc 0.8948 | Test loss 0.2420 | Test Acc 0.9270
epoch 2 | [Baseline] Train loss 0.1966 | Train Acc 0.9409 | Test loss 0.1737 | Test Acc 0.9479
epoch 3 | [Baseline] Train loss 0.1388 | Train Acc 0.9589 | Test loss 0.1846 | Test Acc 0.9467
epoch 4 | [Baseline] Train loss 0.1040 | Train Acc 0.9700 | Test loss 0.1476 | Test Acc 0.9538
epoch 5 | [Baseline] Train loss 0.0799 | Train Acc 0.9753 | Test loss 0.1356 | Test Acc 0.9618
epoch 6 | [Baseline] Train loss 0.0633 | Train Acc 0.9800 | Test loss 0.1477 | Test Acc 0.9622
epoch 7 | [Baseline] Train loss 0.0508 | Train Acc 0.9836 | Test loss 0.1554 | Test Acc 0.9582
epoch 8 | [Baseline] Train loss 0.0468 | Train Acc 0.9844 | Test loss 0.1357 | Test Acc 0.9646
epoch 9 | [Baseline] Train loss 0.0361 | Train Acc 0.9883 | Test loss 0.1743 | Test Acc 0.9586
epoch 10 | [Baseline] Train loss 0.0329 | Train Acc 0.9890 | Test loss 0.1625 | Test Acc 0.9642
epoch 11 | [Baseline] Train loss 0.0253 | Train Acc 0.9919 | Test loss 0.1950 | Test Acc 0.9596
epoch 12 | [Baseline] Train loss 0.0290 | Train Acc 0.9903 | Test loss 0.1727 | Test Acc 0.9646
epoch 13 | [Baseline] Train loss 0.0270 | Train Acc 0.9917 | Test loss 0.2054 | Test Acc 0.9592
epoch 14 | [Baseline] Train loss 0.0307 | Train Acc 0.9905 | Test loss 0.2011 | Test Acc 0.9640
epoch 15 | [Baseline] Train loss 0.0186 | Train Acc 0.9939 | Test loss 0.2010 | Test Acc 0.9668
epoch 16 | [Baseline] Train loss 0.0187 | Train Acc 0.9942 | Test loss 0.1747 | Test Acc 0.9636
epoch 17 | [Baseline] Train loss 0.0255 | Train Acc 0.9924 | Test loss 0.2053 | Test Acc 0.9654
epoch 18 | [Baseline] Train loss 0.0243 | Train Acc 0.9926 | Test loss 0.1583 | Test Acc 0.9703
epoch 19 | [Baseline] Train loss 0.0175 | Train Acc 0.9942 | Test loss 0.1953 | Test Acc 0.9670
epoch 20 | [Baseline] Train loss 0.0226 | Train Acc 0.9931 | Test loss 0.2413 | Test Acc 0.9648
epoch 21 | [Baseline] Train loss 0.0204 | Train Acc 0.9945 | Test loss 0.2181 | Test Acc 0.9668
epoch 22 | [Baseline] Train loss 0.0218 | Train Acc 0.9934 | Test loss 0.2141 | Test Acc 0.9672
epoch 23 | [Baseline] Train loss 0.0166 | Train Acc 0.9946 | Test loss 0.2378 | Test Acc 0.9638
epoch 24 | [Baseline] Train loss 0.0187 | Train Acc 0.9943 | Test loss 0.2273 | Test Acc 0.9693
epoch 25 | [Baseline] Train loss 0.0148 | Train Acc 0.9955 | Test loss 0.2393 | Test Acc 0.9674
epoch 26 | [Baseline] Train loss 0.0194 | Train Acc 0.9940 | Test loss 0.2325 | Test Acc 0.9684
epoch 27 | [Baseline] Train loss 0.0205 | Train Acc 0.9944 | Test loss 0.2574 | Test Acc 0.9628
epoch 28 | [Baseline] Train loss 0.0177 | Train Acc 0.9950 | Test loss 0.2633 | Test Acc 0.9705
epoch 29 | [Baseline] Train loss 0.0189 | Train Acc 0.9948 | Test loss 0.2083 | Test Acc 0.9709Les deux approches finissent au même niveau : environ 97 % de précision en test. Sur ce cas simple, connaître la règle n’apporte pas d’avantage mesurable : avec 30 000 exemples et 19 sommes possibles, un réseau supervisé apprend la tâche aussi bien.
On remarque déjà une différence dans la dynamique : le LTN dépasse 93 % de précision en test dès la première epoch, alors que la baseline part de 84 %.
Addition de nombres à deux chiffres
L’entraînement est identique ; seule la façon de grounder les variables change, pour tenir compte des quatre chiffres :
history_multi = {"train_loss": [], "train_sat": [], "train_acc": [],
                  "test_loss": [], "test_sat": [], "test_acc": []}

optimizer = torch.optim.Adam(Digit_m_d.parameters(), lr=0.001)

for epoch in range(20):
    # planification du paramètre p pour le quantificateur existentiel, comme décrit dans l'article LTN
    if epoch in range(0, 4):
        p = 1
    if epoch in range(4, 8):
        p = 2
    if epoch in range(8, 12):
        p = 4
    if epoch in range(12, 20):
        p = 6
    train_loss, test_loss = 0.0, 0.0
    train_sat, test_sat = 0.0, 0.0
    train_acc, test_acc = 0.0, 0.0
    # étape d'entraînement
    cnn_m_d.train()
    for batch_idx, (operand_images, addition_label) in enumerate(multi_d_train_loader):
        optimizer.zero_grad()
        # on groundes les variables avec les données du batch courant
        images_x1 = ltn.Variable("x1", operand_images[:, 0])
        images_x2 = ltn.Variable("x2", operand_images[:, 1])
        images_y1 = ltn.Variable("y1", operand_images[:, 2])
        images_y2 = ltn.Variable("y2", operand_images[:, 3])
        labels_z = ltn.Variable("z", addition_label)
        sat_agg = Forall(
            ltn.diag(images_x1, images_x2, images_y1, images_y2, labels_z),
            Exists(
                [d_1, d_2, d_3, d_4],
                And(
                    And(Digit_m_d(images_x1, d_1), Digit_m_d(images_x2, d_2)),
                    And(Digit_m_d(images_y1, d_3), Digit_m_d(images_y2, d_4))
                ),
                cond_vars=[d_1, d_2, d_3, d_4, labels_z],
                cond_fn=lambda d1, d2, d3, d4, z: torch.eq(10 * d1.value + d2.value + 10 * d3.value + d4.value, z.value),
                p=p
            )).value
        loss = 1. - sat_agg
        loss.backward()
        optimizer.step()
        train_loss += loss.item()
        train_sat += sat_agg.item()
        # calcul de la précision d'entraînement
        predictions_x1 = torch.argmax(cnn_m_d(operand_images[:, 0].to(ltn.device)), dim=1)
        predictions_x2 = torch.argmax(cnn_m_d(operand_images[:, 1].to(ltn.device)), dim=1)
        predictions_y1 = torch.argmax(cnn_m_d(operand_images[:, 2].to(ltn.device)), dim=1)
        predictions_y2 = torch.argmax(cnn_m_d(operand_images[:, 3].to(ltn.device)), dim=1)
        predictions = 10 * predictions_x1 + predictions_x2 + 10 * predictions_y1 + predictions_y2
        train_acc += torch.count_nonzero(torch.eq(addition_label.to(ltn.device), predictions)) / predictions.shape[0]
    train_loss = train_loss / len(multi_d_train_loader)
    train_sat = train_sat / len(multi_d_train_loader)
    train_acc = train_acc / len(multi_d_train_loader)

    # étape de test
    cnn_m_d.eval()
    with torch.no_grad():
        for batch_idx, (operand_images, addition_label) in enumerate(multi_d_test_loader):
            # on groundes les variables avec les données du batch courant
            images_x1 = ltn.Variable("x1", operand_images[:, 0])
            images_x2 = ltn.Variable("x2", operand_images[:, 1])
            images_y1 = ltn.Variable("y1", operand_images[:, 2])
            images_y2 = ltn.Variable("y2", operand_images[:, 3])
            labels_z = ltn.Variable("z", addition_label)
            sat_agg = Forall(
                ltn.diag(images_x1, images_x2, images_y1, images_y2, labels_z),
                Exists(
                    [d_1, d_2, d_3, d_4],
                    And(
                        And(Digit_m_d(images_x1, d_1), Digit_m_d(images_x2, d_2)),
                        And(Digit_m_d(images_y1, d_3), Digit_m_d(images_y2, d_4))
                    ),
                    cond_vars=[d_1, d_2, d_3, d_4, labels_z],
                    cond_fn=lambda d1, d2, d3, d4, z: torch.eq(10 * d1.value + d2.value + 10 * d3.value + d4.value, z.value),
                    p=p
                )).value
            loss = 1. - sat_agg
            test_loss += loss.item()
            test_sat += sat_agg.item()
            # calcul de la précision de test
            predictions_x1 = torch.argmax(cnn_m_d(operand_images[:, 0].to(ltn.device)), dim=1)
            predictions_x2 = torch.argmax(cnn_m_d(operand_images[:, 1].to(ltn.device)), dim=1)
            predictions_y1 = torch.argmax(cnn_m_d(operand_images[:, 2].to(ltn.device)), dim=1)
            predictions_y2 = torch.argmax(cnn_m_d(operand_images[:, 3].to(ltn.device)), dim=1)
            predictions = 10 * predictions_x1 + predictions_x2 + 10 * predictions_y1 + predictions_y2
            test_acc += torch.count_nonzero(torch.eq(addition_label.to(ltn.device), predictions)) / predictions.shape[0]
    test_loss = test_loss / len(multi_d_test_loader)
    test_sat = test_sat / len(multi_d_test_loader)
    test_acc = test_acc / len(multi_d_test_loader)

    # enregistrement de l'historique
    history_multi["train_loss"].append(float(train_loss))
    history_multi["train_sat"].append(float(train_sat))
    history_multi["train_acc"].append(float(train_acc))
    history_multi["test_loss"].append(float(test_loss))
    history_multi["test_sat"].append(float(test_sat))
    history_multi["test_acc"].append(float(test_acc))

    # affichage des métriques à chaque epoch
    print(" epoch %d | Train loss %.4f | Train Sat %.4f | Train Acc %.4f | Test loss %.4f | Test Sat %.4f |"
                " Test Acc %.4f " %
          (epoch, train_loss, train_sat, train_acc, test_loss, test_sat, test_acc))
epoch 0 | Train loss 0.9897 | Train Sat 0.0103 | Train Acc 0.5497 | Test loss 0.9832 | Test Sat 0.0168 | Test Acc 0.8180
epoch 1 | Train loss 0.9833 | Train Sat 0.0167 | Train Acc 0.8576 | Test loss 0.9822 | Test Sat 0.0178 | Test Acc 0.8699
epoch 2 | Train loss 0.9824 | Train Sat 0.0176 | Train Acc 0.8962 | Test loss 0.9821 | Test Sat 0.0179 | Test Acc 0.8778
epoch 3 | Train loss 0.9826 | Train Sat 0.0174 | Train Acc 0.8917 | Test loss 0.9826 | Test Sat 0.0174 | Test Acc 0.8382
epoch 4 | Train loss 0.8840 | Train Sat 0.1160 | Train Acc 0.8997 | Test loss 0.8773 | Test Sat 0.1227 | Test Acc 0.9260
epoch 5 | Train loss 0.8785 | Train Sat 0.1215 | Train Acc 0.9329 | Test loss 0.8775 | Test Sat 0.1225 | Test Acc 0.9252
epoch 6 | Train loss 0.8764 | Train Sat 0.1236 | Train Acc 0.9444 | Test loss 0.8749 | Test Sat 0.1251 | Test Acc 0.9415
epoch 7 | Train loss 0.8757 | Train Sat 0.1243 | Train Acc 0.9489 | Test loss 0.8756 | Test Sat 0.1244 | Test Acc 0.9375
epoch 8 | Train loss 0.6739 | Train Sat 0.3261 | Train Acc 0.9356 | Test loss 0.6760 | Test Sat 0.3240 | Test Acc 0.9173
epoch 9 | Train loss 0.6675 | Train Sat 0.3325 | Train Acc 0.9474 | Test loss 0.6676 | Test Sat 0.3324 | Test Acc 0.9363
epoch 10 | Train loss 0.6613 | Train Sat 0.3387 | Train Acc 0.9593 | Test loss 0.6636 | Test Sat 0.3364 | Test Acc 0.9450
epoch 11 | Train loss 0.6597 | Train Sat 0.3403 | Train Acc 0.9617 | Test loss 0.6631 | Test Sat 0.3369 | Test Acc 0.9466
epoch 12 | Train loss 0.5290 | Train Sat 0.4710 | Train Acc 0.9610 | Test loss 0.5342 | Test Sat 0.4658 | Test Acc 0.9438
epoch 13 | Train loss 0.5255 | Train Sat 0.4745 | Train Acc 0.9633 | Test loss 0.5264 | Test Sat 0.4736 | Test Acc 0.9561
epoch 14 | Train loss 0.5240 | Train Sat 0.4760 | Train Acc 0.9651 | Test loss 0.5314 | Test Sat 0.4686 | Test Acc 0.9478
epoch 15 | Train loss 0.5213 | Train Sat 0.4787 | Train Acc 0.9692 | Test loss 0.5298 | Test Sat 0.4702 | Test Acc 0.9494
epoch 16 | Train loss 0.5197 | Train Sat 0.4803 | Train Acc 0.9705 | Test loss 0.5289 | Test Sat 0.4711 | Test Acc 0.9521
epoch 17 | Train loss 0.5191 | Train Sat 0.4809 | Train Acc 0.9717 | Test loss 0.5324 | Test Sat 0.4676 | Test Acc 0.9470
epoch 18 | Train loss 0.5195 | Train Sat 0.4805 | Train Acc 0.9706 | Test loss 0.5288 | Test Sat 0.4712 | Test Acc 0.9529
epoch 19 | Train loss 0.5189 | Train Sat 0.4811 | Train Acc 0.9711 | Test loss 0.5336 | Test Sat 0.4664 | Test Acc 0.9454Le connecteur est binaire : il faut donc imbriquer les conjonctions pour combiner les quatre degrés de vérité. Le produit étant associatif et commutatif, l’ordre des regroupements ne change pas le résultat.
La baseline suit le même principe, avec 4 images en entrée et 199 classes en sortie :
history_baseline_multi = {"train_loss": [], "train_acc": [], "test_loss": [], "test_acc": []}

optimizer_baseline_m = torch.optim.Adam(baseline_m_d.parameters(), lr=0.001)
criterion = torch.nn.CrossEntropyLoss()

for epoch in range(30):
    train_loss, train_acc = 0.0, 0.0
    # étape d'entraînement
    baseline_m_d.train()
    for batch_idx, (operand_images, addition_label) in enumerate(multi_d_train_loader):
        images_x1 = operand_images[:, 0].to(ltn.device)
        images_x2 = operand_images[:, 1].to(ltn.device)
        images_y1 = operand_images[:, 2].to(ltn.device)
        images_y2 = operand_images[:, 3].to(ltn.device)
        labels = addition_label.to(ltn.device).long()

        optimizer_baseline_m.zero_grad()
        logits = baseline_m_d([images_x1, images_x2, images_y1, images_y2])
        loss = criterion(logits, labels)
        loss.backward()
        optimizer_baseline_m.step()

        train_loss += loss.item()
        predictions = torch.argmax(logits, dim=1)
        train_acc += torch.count_nonzero(torch.eq(labels, predictions)) / predictions.shape[0]
    train_loss = train_loss / len(multi_d_train_loader)
    train_acc = train_acc / len(multi_d_train_loader)

    # étape de test
    test_loss, test_acc = 0.0, 0.0
    baseline_m_d.eval()
    with torch.no_grad():
        for batch_idx, (operand_images, addition_label) in enumerate(multi_d_test_loader):
            images_x1 = operand_images[:, 0].to(ltn.device)
            images_x2 = operand_images[:, 1].to(ltn.device)
            images_y1 = operand_images[:, 2].to(ltn.device)
            images_y2 = operand_images[:, 3].to(ltn.device)
            labels = addition_label.to(ltn.device).long()

            logits = baseline_m_d([images_x1, images_x2, images_y1, images_y2])
            loss = criterion(logits, labels)

            test_loss += loss.item()
            predictions = torch.argmax(logits, dim=1)
            test_acc += torch.count_nonzero(torch.eq(labels, predictions)) / predictions.shape[0]
    test_loss = test_loss / len(multi_d_test_loader)
    test_acc = test_acc / len(multi_d_test_loader)

    history_baseline_multi["train_loss"].append(float(train_loss))
    history_baseline_multi["train_acc"].append(float(train_acc))
    history_baseline_multi["test_loss"].append(float(test_loss))
    history_baseline_multi["test_acc"].append(float(test_acc))

    print(" epoch %d | [Baseline] Train loss %.4f | Train Acc %.4f | Test loss %.4f | Test Acc %.4f " %
          (epoch, train_loss, train_acc, test_loss, test_acc))
epoch 0 | [Baseline] Train loss 4.9616 | Train Acc 0.0147 | Test loss 4.6097 | Test Acc 0.0206
epoch 1 | [Baseline] Train loss 4.3830 | Train Acc 0.0333 | Test loss 4.3773 | Test Acc 0.0320
epoch 2 | [Baseline] Train loss 4.0406 | Train Acc 0.0649 | Test loss 4.2692 | Test Acc 0.0388
epoch 3 | [Baseline] Train loss 3.6883 | Train Acc 0.1100 | Test loss 4.1066 | Test Acc 0.0676
epoch 4 | [Baseline] Train loss 3.1502 | Train Acc 0.1911 | Test loss 3.7083 | Test Acc 0.1040
epoch 5 | [Baseline] Train loss 2.5091 | Train Acc 0.3078 | Test loss 3.3443 | Test Acc 0.1487
epoch 6 | [Baseline] Train loss 1.9065 | Train Acc 0.4393 | Test loss 3.0455 | Test Acc 0.2065
epoch 7 | [Baseline] Train loss 1.4043 | Train Acc 0.5754 | Test loss 2.8107 | Test Acc 0.2627
epoch 8 | [Baseline] Train loss 1.0039 | Train Acc 0.6915 | Test loss 2.7919 | Test Acc 0.3074
epoch 9 | [Baseline] Train loss 0.7097 | Train Acc 0.7794 | Test loss 2.7845 | Test Acc 0.3212
epoch 10 | [Baseline] Train loss 0.4998 | Train Acc 0.8419 | Test loss 2.9036 | Test Acc 0.3402
epoch 11 | [Baseline] Train loss 0.3643 | Train Acc 0.8850 | Test loss 3.0704 | Test Acc 0.3552
epoch 12 | [Baseline] Train loss 0.2681 | Train Acc 0.9129 | Test loss 3.1775 | Test Acc 0.3675
epoch 13 | [Baseline] Train loss 0.2111 | Train Acc 0.9322 | Test loss 3.2700 | Test Acc 0.3908
epoch 14 | [Baseline] Train loss 0.2028 | Train Acc 0.9321 | Test loss 3.3315 | Test Acc 0.3952
epoch 15 | [Baseline] Train loss 0.1517 | Train Acc 0.9515 | Test loss 3.6011 | Test Acc 0.3821
epoch 16 | [Baseline] Train loss 0.1467 | Train Acc 0.9514 | Test loss 3.5471 | Test Acc 0.3916
epoch 17 | [Baseline] Train loss 0.1561 | Train Acc 0.9474 | Test loss 3.7553 | Test Acc 0.3833
epoch 18 | [Baseline] Train loss 0.1457 | Train Acc 0.9504 | Test loss 3.6462 | Test Acc 0.4110
epoch 19 | [Baseline] Train loss 0.1029 | Train Acc 0.9671 | Test loss 3.6674 | Test Acc 0.4229
epoch 20 | [Baseline] Train loss 0.1139 | Train Acc 0.9619 | Test loss 3.9440 | Test Acc 0.4102
epoch 21 | [Baseline] Train loss 0.1303 | Train Acc 0.9573 | Test loss 3.7222 | Test Acc 0.4260
epoch 22 | [Baseline] Train loss 0.0985 | Train Acc 0.9679 | Test loss 3.9490 | Test Acc 0.4118
epoch 23 | [Baseline] Train loss 0.1044 | Train Acc 0.9641 | Test loss 3.9776 | Test Acc 0.4233
epoch 24 | [Baseline] Train loss 0.0848 | Train Acc 0.9718 | Test loss 3.9414 | Test Acc 0.4213
epoch 25 | [Baseline] Train loss 0.0752 | Train Acc 0.9753 | Test loss 3.9455 | Test Acc 0.4355
epoch 26 | [Baseline] Train loss 0.1106 | Train Acc 0.9649 | Test loss 3.9096 | Test Acc 0.4407
epoch 27 | [Baseline] Train loss 0.1121 | Train Acc 0.9621 | Test loss 4.0718 | Test Acc 0.4557
epoch 28 | [Baseline] Train loss 0.0972 | Train Acc 0.9681 | Test loss 3.8898 | Test Acc 0.4415
epoch 29 | [Baseline] Train loss 0.0640 | Train Acc 0.9788 | Test loss 4.0434 | Test Acc 0.4490Cette fois, l’écart est net : le LTN atteint environ 95 % en test, la baseline plafonne à environ 45 %, alors même que sa précision d’entraînement dépasse 97 %.
Les résultats
Précision en test à la dernière epoch :
| LTN | Baseline | |
|---|---|---|
| Addition de deux chiffres | 97 % | 97 % |
| Addition de nombres à deux chiffres | 95 % | 45 % |
Pour visualiser l’entraînement, on trace pour chaque tâche la précision des deux approches et la satisfaction du LTN, avec les changements de . Il s’agit d’un seul entraînement, sans moyenne sur plusieurs graines aléatoires, faute de puissance de calcul : les courbes n’ont donc pas de zone d’incertitude.
import matplotlib.pyplot as plt

def plot_task_with_baseline(history_ltn, history_baseline, title,
                             p_transitions=(4, 8, 12), p_labels=(1, 2, 4, 6),
                             max_epochs=20):
    epochs = range(max_epochs)
    fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))

    colors = {
        "baseline_train": "#8fc7e8", "baseline_test": "#1f6fb2",
        "ltn_train": "#a8d98a", "ltn_test": "#2e8b3d",
    }

    # --- Accuracy ---
    ax = axes[0]
    ax.plot(epochs, history_baseline["train_acc"][:max_epochs],
             color=colors["baseline_train"], lw=1, label="Baseline (train)")
    ax.plot(epochs, history_baseline["test_acc"][:max_epochs],
             color=colors["baseline_test"], lw=1.5, ls="--", label="Baseline (test)")
    ax.plot(epochs, history_ltn["train_acc"][:max_epochs],
             color=colors["ltn_train"], lw=1, label="LTN (train)")
    ax.plot(epochs, history_ltn["test_acc"][:max_epochs],
             color=colors["ltn_test"], lw=1.5, ls="--", label="LTN (test)")
    ax.set_ylim(0, 1.02); ax.set_xlim(0, max_epochs - 1)
    ax.set_xlabel("Epoch"); ax.set_ylabel("Accuracy")
    ax.set_title(f"{title} examples")

    # --- Sat ---
    ax = axes[1]
    ax.plot(epochs, history_ltn["train_sat"][:max_epochs],
             color=colors["ltn_train"], lw=1, label="LTN (train)")
    ax.plot(epochs, history_ltn["test_sat"][:max_epochs],
             color=colors["ltn_test"], lw=1.5, ls="--", label="LTN (test)")
    for t in p_transitions:
        ax.axvline(t, color="grey", ls=":", lw=0.8)
    boundaries = [0] + list(p_transitions) + [max_epochs - 1]
    for i, p in enumerate(p_labels):
        mid = (boundaries[i] + boundaries[i + 1]) / 2
        ax.text(mid, 0.95, f"$p_2={p}$", ha="center", fontsize=8, color="grey")
    ax.set_ylim(0, 1.02); ax.set_xlim(0, max_epochs - 1)
    ax.set_xlabel("Epoch"); ax.set_ylabel("Sat")
    ax.set_title(f"{title} examples")

    # Suppression des bordures haut/droite sur les deux axes
    for a in axes:
        a.spines["top"].set_visible(False)
        a.spines["right"].set_visible(False)

    handles, labels_ = axes[0].get_legend_handles_labels()
    fig.legend(handles, labels_, loc="center right", bbox_to_anchor=(1.18, 0.5))
    plt.tight_layout()
    plt.show()

plot_task_with_baseline(history_single, history_baseline_single, "30000")
plot_task_with_baseline(history_multi, history_baseline_multi, "15000")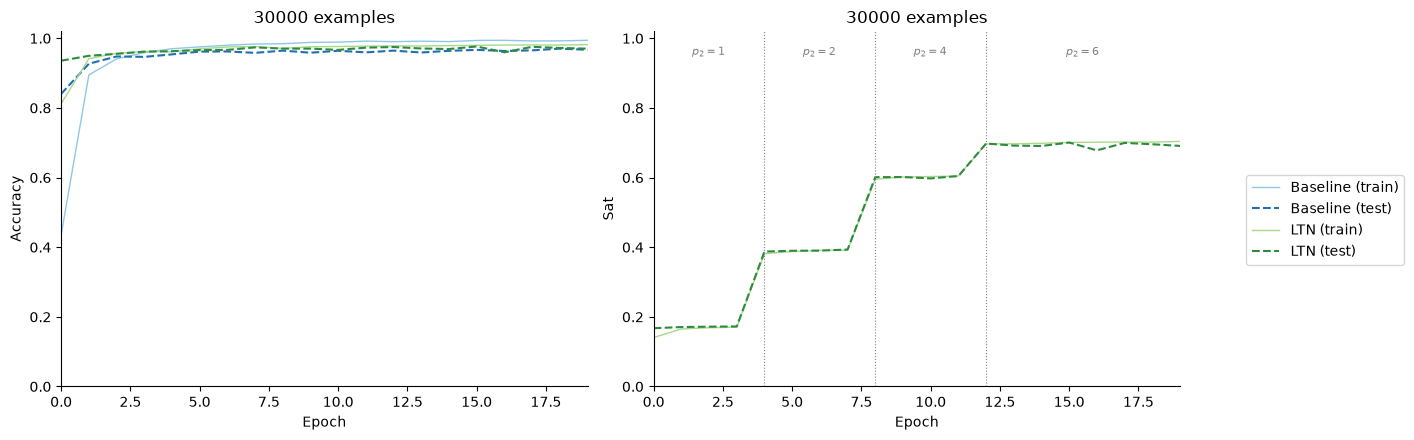
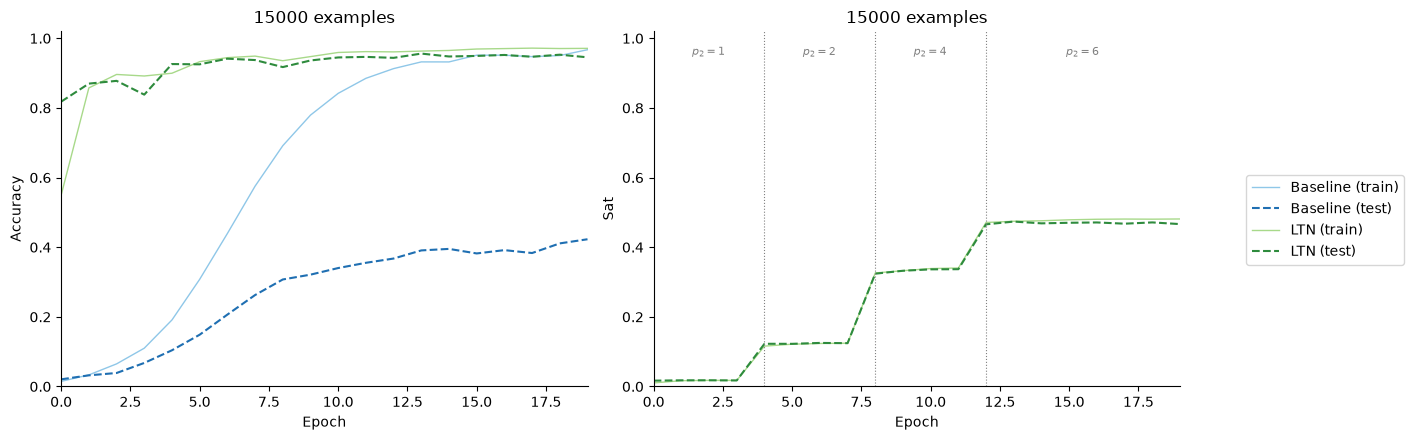
Les courbes ne montrent que les 20 premières epochs de la baseline, pour les aligner sur celles du LTN : sa précision de test finale, à l’epoch 30, est de 45 %.
Sur l’addition de deux chiffres, les courbes de test des deux approches se superposent presque du début à la fin.
Sur l’addition de nombres à deux chiffres, la baseline surapprend : sa précision d’entraînement continue de monter, mais sa précision de test plafonne. Elle mémorise les exemples sans généraliser. Le LTN garde ses courbes d’entraînement et de test proches l’une de l’autre.
La raison tient à la structure du problème. La baseline doit prédire directement la somme parmi 199 classes, avec 15 000 exemples, soit peu d’exemples par classe, et les sommes extrêmes sont très rares. Le LTN, lui, n’apprend à distinguer que 10 chiffres, et chaque image d’entraînement lui fournit un signal sur l’un d’eux ; la règle logique se charge ensuite de combiner les chiffres pour obtenir la somme. Il n’a donc jamais besoin d’apprendre les 199 sommes possibles.
La satisfaction progresse par paliers, qui coïncident exactement avec les changements de . Il faut bien lire ces sauts : pour des degrés de vérité fixés, pMean augmente mécaniquement avec , puisqu’il se rapproche du maximum. Une grande partie de chaque saut vient donc du changement de la mesure elle-même, et non d’un progrès soudain du classifieur, comme le confirme la précision, qui ne fait pas de saut aux mêmes moments. Les niveaux de satisfaction ne sont comparables qu’à égal.
À retenir
- Un LTN peut apprendre un classifieur sans aucune étiquette individuelle, à partir d’une seule contrainte logique sur la somme : les chiffres sont des variables latentes, que seule la logique relie aux données.
- La quantification diagonale associe chaque paire d’images à son propre résultat, et la quantification gardée injecte la règle .
- Sur l’addition de deux chiffres, LTN et baseline font jeu égal (97 %). Sur l’addition de nombres à deux chiffres, le LTN reste à 95 % quand la baseline tombe à 45 % : en décomposant le problème en chiffres, la logique évite d’avoir à apprendre 199 classes avec peu d’exemples.
- Le planning de applique la leçon de la partie 3 : un faible au début pour répartir le gradient, puis plus élevé quand le classifieur devient fiable.
Cette étude de cas conclut la série. Elle illustre l’idée centrale de LTN : la logique fixe la forme du raisonnement, ici « la somme des chiffres vaut le résultat », et le contenu, reconnaître chaque chiffre, est appris par descente de gradient.
Le notebook complet de cette étude de cas est disponible dans mon dépôt.
Notes de la semaine
Chaque dimanche, je partage ce que j'ai appris : articles de recherche, idées, expériences et questions qui me sont restées en tête.
Vous pouvez vous désabonner à tout moment en un clic.
Discussion sur cet article0
Rejoindre la discussion
A secure sign-in link will be sent to your email address.
Chargement de la discussion...