Dans les trois premières parties, on a appris à construire des objets LTN et à évaluer des formules, mais jamais à faire en sorte qu’un prédicat s’améliore. C’est l’objet de cette dernière partie : apprendre des symboles du langage (prédicats, fonctions, constantes) en prenant la satisfaction d’une base de connaissances comme objectif d’entraînement.
Une base de connaissances est simplement un ensemble de formules qu’on souhaite voir vérifiées en même temps. La satisfaire ne veut pas dire rendre chaque formule strictement vraie, comme en logique classique, mais trouver les paramètres qui rendent le degré de vérité de chaque formule le plus proche possible de 1. C’est un problème d’optimisation continue, exactement comme la minimisation d’une fonction de perte, à ceci près qu’on maximise un degré de satisfaction logique plutôt qu’une proximité à des étiquettes.
Pendant l’entraînement, ce qui change, ce sont les poids des prédicats et fonctions apprenables (les réseaux de neurones qu’on a construits jusqu’ici), et éventuellement les valeurs des constantes entraînables. La structure logique des formules, elle, reste fixe.
Un problème de classification par proximité
Le domaine est le carré : des points du plan dont les deux coordonnées sont entre 0 et 4. On dispose de 19 points et on veut deviner leur classe. Seuls deux d’entre eux sont étiquetés : le point , de classe , et le point , de classe . Les 17 autres n’ont aucune étiquette.
Avec deux exemples étiquetés, un classifieur entraîné de façon purement supervisée n’apprendrait rien d’utile. L’idée est de compenser ce manque de données par des connaissances a priori sur le problème, exprimées en deux hypothèses :
- les classes et sont mutuellement exclusives : un point ne peut pas appartenir aux deux ;
- deux points proches devraient avoir la même étiquette.
C’est la seconde hypothèse qui fera l’essentiel du travail. Elle rappelle le principe des k plus proches voisins : un point proche de appartient probablement à la même classe que . On va la traduire en une règle logique, qui permettra au modèle de classer tous les points à partir des deux seuls exemples étiquetés, sans jamais recevoir l’étiquette des 17 autres.
import torch
import numpy as np
import ltn
import matplotlib.pyplot as plt

points = np.array(
        [[0.4,0.3], [1.2,0.3], [2.2,1.3], [1.7,1.0], [0.5,0.5], [0.3, 1.5], [1.3, 1.1], [0.9, 1.7],
        [3.4,3.3], [3.2,3.3], [3.2,2.3], [2.7,2.0], [3.5,3.5], [3.3, 2.5], [3.3, 1.1], [1.9, 3.7], [1.3, 3.5],
        [3.3, 1.1],[3.9, 3.7]])
point_a = [3.3, 2.5]
point_b = [1.3, 1.1]
fig, ax = plt.subplots()
ax.set_xlim(0, 4)
ax.set_ylim(0, 4)
ax.scatter(points[:,0], points[:,1], color="black", label="unknown")
ax.scatter(point_a[0], point_a[1], color="blue", label="a")
ax.scatter(point_b[0], point_b[1], color="red", label="b")
ax.set_title("Dataset of individuals")
plt.legend();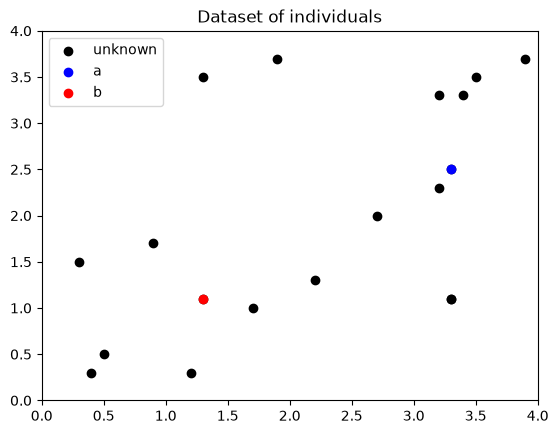
La base de connaissances
On définit un prédicat d’appartenance , où est un point et un label encodé en one-hot : pour la classe , pour la classe . répond à la question « à quel degré le point appartient-il à la classe ? ».
est un petit perceptron multicouche. Sa dernière couche utilise un softmax plutôt qu’une sigmoïde, et ce choix traduit directement la première hypothèse. Une sigmoïde évaluerait chaque classe indépendamment ; le softmax répartit une masse de probabilité totale égale à 1 entre les classes, ce qui les rend mutuellement exclusives.
La base de connaissances contient trois formules :
où :
- et sont les deux points étiquetés, et , les labels one-hot de et ;
- et sont des variables qui parcourent tous les points ;
- est une variable qui parcourt les deux labels ;
- mesure la similarité entre deux points : , la construction déjà rencontrée dans les parties précédentes.
Les deux premières formules imposent que soit reconnu comme étant de classe , et de classe . La troisième traduit l’hypothèse de proximité : pour toute paire de points et pour chaque label, si les deux points sont similaires, alors ils doivent recevoir le même verdict pour ce label. C’est ce qu’exprime l’équivalence à l’intérieur de l’implication.
L’objectif est d’apprendre de façon à maximiser la satisfaction globale de . En notant les poids du réseau qui implémente , on cherche :
où agrège les degrés de vérité de toutes les formules de en une seule valeur. On y reviendra un peu plus bas.
Définissons d’abord les prédicats, avec les mêmes noms que dans la formulation mathématique :
# Prédicat C
class ModelC(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.elu = torch.nn.ELU()
        self.softmax = torch.nn.Softmax(dim=1)
        self.dense1 = torch.nn.Linear(2, 5)
        self.dense2 = torch.nn.Linear(5, 5)
        self.dense3 = torch.nn.Linear(5, 2)

    def forward(self, x, l):
        """x : un point, l : un label one-hot"""
        x = self.elu(self.dense1(x))
        x = self.elu(self.dense2(x))
        prob = self.softmax(self.dense3(x))
        return torch.sum(prob * l, dim=1)

C = ltn.Predicate(ModelC())

# Prédicat Sim
Sim = ltn.Predicate(func=lambda u, v: torch.exp(-1. * torch.sqrt(torch.sum(torch.square(u - v), dim=1))))
Puis les variables et les constantes : et parcourent les 19 points, et sont les deux points étiquetés, et leurs labels, et parcourt les deux labels possibles.
x1 = ltn.Variable("x1", torch.tensor(points))
x2 = ltn.Variable("x2", torch.tensor(points))
a = ltn.Constant(torch.tensor([3.3, 2.5]))
b = ltn.Constant(torch.tensor([1.3, 1.1]))
l_a = ltn.Constant(torch.tensor([1, 0]))
l_b = ltn.Constant(torch.tensor([0, 1]))
l = ltn.Variable("l", torch.tensor([[1, 0], [0, 1]]))
Visualisons la similarité entre chaque point et , telle que la calcule : plus la ligne qui relie un point à est épaisse et opaque, plus ils sont similaires.
similarities_to_a = Sim(x1, a).value
fig, ax = plt.subplots()
ax.set_xlim(0, 4)
ax.set_ylim(0, 4)
ax.scatter(points[:,0], points[:,1], color="black")
ax.scatter(a.value[0], a.value[1], color="blue")
ax.set_title("Illustrating the similarities of each point to a")
for i, sim_to_a in enumerate(similarities_to_a):
    plt.plot([points[i,0], a.value[0]], [points[i,1],a.value[1]], alpha=float(sim_to_a.numpy()), color="blue")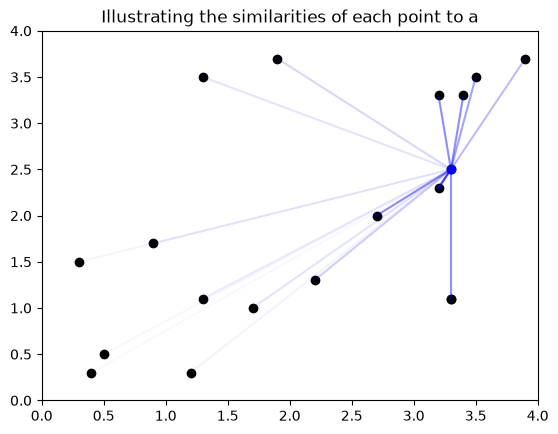
Pour les connecteurs, on utilise la configuration produit vue dans la partie 3. Un nouvel opérateur apparaît : l’équivalence . LTN ne l’implémente pas comme un opérateur indépendant, mais la construit à partir de deux opérateurs connus, selon l’équivalence classique . ltn.fuzzy_ops.Equiv prend en entrée la t-norme et l’implication à utiliser pour cette construction.
Not = ltn.Connective(ltn.fuzzy_ops.NotStandard())
And = ltn.Connective(ltn.fuzzy_ops.AndProd())
Or = ltn.Connective(ltn.fuzzy_ops.OrProbSum())
Implies = ltn.Connective(ltn.fuzzy_ops.ImpliesReichenbach())
Equiv = ltn.Connective(ltn.fuzzy_ops.Equiv(ltn.fuzzy_ops.AndProd(), ltn.fuzzy_ops.ImpliesReichenbach()))
Forall = ltn.Quantifier(ltn.fuzzy_ops.AggregPMeanError(p=2), quantifier="f")
Exists = ltn.Quantifier(ltn.fuzzy_ops.AggregPMean(p=6), quantifier="e")
Des formules closes à une fonction de perte
Quand contient plusieurs formules, leurs degrés de vérité doivent être agrégés en une seule valeur : c’est le rôle de . Il ne s’applique qu’à des formules closes, c’est-à-dire sans aucune variable libre : toutes leurs variables ont été capturées par un quantificateur. Si une formule contenait encore une variable libre, son degré de vérité ne serait pas un nombre unique mais un tenseur de valeurs, une par valeur de la variable, et ne saurait pas laquelle retenir.
Quelques exemples pour fixer ce critère :
- a deux variables libres : elle n’est pas close, et son évaluation donne une matrice.
- n’est pas close non plus : reste libre, et le résultat est un vecteur, une valeur par .
- est close : son évaluation donne un scalaire.
- est close aussi. Seul compte le fait que toutes les variables soient quantifiées, pas l’ordre ni le type des quantificateurs.
Dans notre base, et sont closes d’emblée, puisqu’elles ne contiennent que des constantes : il n’y a rien à quantifier. La troisième ne devient close que grâce au qui capture ses trois variables.
En LTN, est disponible via ltn.fuzzy_ops.SatAgg, dont le constructeur prend un opérateur d’agrégation. On recommande là encore pMeanError, le même que pour , et c’est le choix par défaut. y joue le même rôle que pour les quantificateurs : plus il est faible, plus l’agrégation se rapproche d’une moyenne des formules ; plus il est élevé, plus elle se rapproche de la pire formule de . SatAgg accepte directement des LTNObject : inutile de passer par .value.
Enfin, on veut maximiser la satisfaction, alors que les optimiseurs de PyTorch minimisent une perte. On définit donc la perte comme : la minimiser revient exactement à maximiser la satisfaction.
Un exemple calculé à la main
Avant de lancer l’entraînement, suivons le calcul de la troisième formule sur un cas assez petit pour être fait à la main. On utilise la configuration produit :
- implication de Reichenbach : ;
- équivalence : , le produit des deux implications.
Dans ces formules, et sont des scalaires : des degrés de vérité individuels dans .
Les données
On prend 3 points au lieu de 19 :
et parcourent indépendamment ce même domaine, donc toute formule se calcule sur le produit cartésien, une grille indexée par .
Étape 1 : Sim(x1, x2)
La matrice est symétrique, et sa diagonale vaut 1 puisque chaque point est identique à lui-même. et sont très proches, est loin des deux autres.
Étape 2 : C(x, l), le prédicat de confiance
est une fonction d’un seul point et d’un label. Supposons que le réseau, pas encore entraîné, donne les confiances suivantes (une ligne par point, une colonne par label) :
et parcourent le même domaine avec le même prédicat : et sont la même fonction, évaluée à des indices différents ( pour , pour ). Pour un label fixé, on extrait donc un vecteur indexé par les points :
Grâce au softmax, les deux colonnes somment à 1 : terme à terme.
Étape 3 : Equiv(C(x1, l), C(x2, l))
et sont deux valeurs du même vecteur, prises à deux indices. Pour , avec :
La matrice est symétrique, puisque par construction :
Pourquoi ? Comme , on a . Or :
donc :
Les deux matrices ont exactement les mêmes 9 valeurs, pour une raison algébrique et non par coïncidence.
Étape 4 : Implies(Sim(x1, x2), Equiv(C(x1, l), C(x2, l)))
et sont indexés par la même grille , puisque les deux viennent du grounding de et . L’implication se calcule donc case par case :
On y lit bien la règle : quand deux points sont éloignés ( proche de 0), l’implication est presque vraie quel que soit leur désaccord, car la règle ne dit rien sur eux. Quand ils sont proches, c’est l’accord de leurs confiances qui décide.
Lecture d’une cellule
Chaque cellule répond à une question précise, fixée par les trois indices : en prenant , et le label , à quel degré l’axiome « s’ils sont similaires, ils reçoivent la même confiance pour ce label » est-il vérifié ?
Prenons :
- On instancie , et .
- : les deux points sont très proches.
- : le réseau donne 90 % de confiance à pour la classe , mais seulement 50 % à . Les deux verdicts sont en désaccord.
- .
Une valeur de , loin de 1, signale une violation de l’axiome : deux points proches devraient recevoir des confiances proches pour la classe . C’est ce type de cellule qui produira un fort signal de gradient, poussant le réseau à rapprocher et .
Étape 5 : le quantificateur ∀
Forall([x1, x2, l], …) agrège les cellules avec pMeanError et :
| nombre de cases par label | ||||
|---|---|---|---|---|
| 1 | ||||
| 1 | ||||
| 1 | ||||
| , | 2 | |||
| , | 2 | |||
| , | 2 |
Pour un label, la somme vaut , et comme , on la compte deux fois :
Remarquez la diagonale. On pourrait croire que comparer un point à lui-même est trivialement vrai, mais ce n’est pas le cas en logique floue : ne vaut 1 que si vaut 0 ou 1. Pour , dont la confiance est de , la cellule ne vaut que , et c’est même la pire cellule du tableau. Le code d’entraînement ci-dessous agrège sur toutes les paires, diagonale comprise : ces cellules poussent donc le réseau à donner des verdicts tranchés, proches de 0 ou de 1, plutôt que des confiances indécises.
La perte
La perte combine enfin les trois formules de :
Pourquoi comparer toutes les paires ?
On pourrait imaginer une règle plus simple : comparer chaque point inconnu à et à seulement, et en déduire sa classe, comme un algorithme des plus proches voisins avec deux voisins de référence :
Cette règle reviendrait à n’éclairer que les points suffisamment proches des deux seules lampes et : un point trop éloigné resterait dans le noir, même entouré de points déjà bien éclairés. La règle de , elle, compare toutes les paires : chaque point éclairé illumine à son tour ses voisins, et la lumière se propage d’un bout à l’autre du nuage de points, même très loin de et de , tant qu’il existe un chemin de proximités successives.
C’est ce qui justifie le coût de calcul, paires au lieu de : ce n’est pas une lourdeur inutile, c’est ce qui permet à l’information de circuler à travers tout le graphe de proximités.
L’entraînement
Chaque itération calcule les degrés de vérité des trois formules de (phase forward), puis ajuste les poids de par rétropropagation pour réduire la perte (phase backward).
# par défaut, SatAgg utilise pMeanError
sat_agg = ltn.fuzzy_ops.SatAgg()

# on apprend les paramètres du prédicat C
optimizer = torch.optim.Adam(C.parameters(), lr=0.001)

for epoch in range(2000):
    optimizer.zero_grad()
    loss = 1. - sat_agg(
        C(a, l_a),
        C(b, l_b),
        Forall([x1, x2, l], Implies(Sim(x1, x2), Equiv(C(x1, l), C(x2, l))))
    )
    loss.backward()
    optimizer.step()
    if epoch%200 == 0:
        print("Epoch %d: Sat Level %.3f "%(epoch, 1 - loss.item()))
print("Training finished at Epoch %d with Sat Level %.3f" %(epoch, 1 - loss.item()))
Epoch 0: Sat Level 0.487
Epoch 200: Sat Level 0.726
Epoch 400: Sat Level 0.935
Epoch 600: Sat Level 0.955
Epoch 800: Sat Level 0.958
Epoch 1000: Sat Level 0.959
Epoch 1200: Sat Level 0.959
Epoch 1400: Sat Level 0.959
Epoch 1600: Sat Level 0.959
Epoch 1800: Sat Level 0.959
Training finished at Epoch 1999 with Sat Level 0.960La satisfaction passe de 0.49 à 0.96 en quelques centaines d’itérations. Le système a appris à reconnaître les points proches de comme étant de classe , et ceux proches de comme étant de classe , en s’appuyant uniquement sur les règles de la base de connaissances, sans jamais recevoir l’étiquette des 17 autres points.
Les deux graphiques ci-dessous le montrent : la couleur est d’autant plus claire que est satisfait. À gauche, ; à droite, .
fig = plt.figure(figsize=(10, 3))

fig.add_subplot(1, 2, 1)
plt.scatter(x1.value[:, 0], x1.value[:, 1], c=C(x1, l_a).value.detach().numpy(), vmin=0, vmax=1)
plt.scatter(a.value[0], a.value[1], marker="x", color="red", s=100, label="a")
plt.scatter(b.value[0], b.value[1], marker="x", color="blue", s=100, label="b")
plt.title("C(x,l_a)")
plt.legend()
plt.colorbar()

fig.add_subplot(1, 2, 2)
plt.scatter(x1.value[:, 0], x1.value[:, 1], c=C(x1, l_b).value.detach().numpy(), vmin=0, vmax=1)
plt.scatter(a.value[0], a.value[1], marker="x", color="red", s=100, label="a")
plt.scatter(b.value[0], b.value[1], marker="x", color="blue", s=100, label="b")
plt.title("C(x,l_b)")
plt.legend()
plt.colorbar()

plt.show();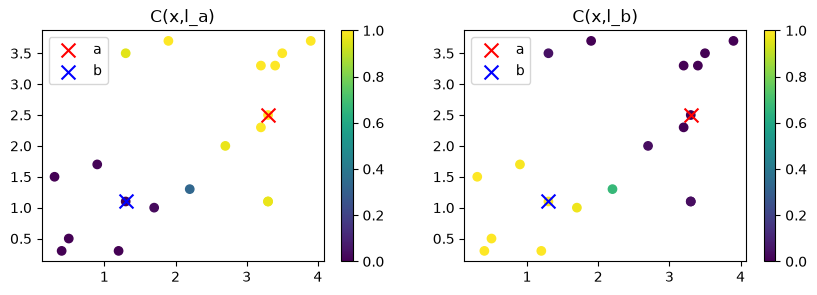
On y voit la propagation à l’œuvre : les points en haut à gauche, autour de , sont presque aussi éloignés de que de , et pourtant ils sont classés , grâce à la chaîne de voisins qui les relie à . Seul le point , entre les deux groupes, reçoit un verdict peu tranché.
Travailler par mini-batchs
Dans la plupart des tâches d’apprentissage, on travaille par batchs plutôt qu’avec tout le dataset à chaque itération, notamment quand il est trop volumineux pour être traité d’un coup.
En LTN, cela ne demande aucun mécanisme particulier : il suffit de regrounder les variables avec des valeurs différentes à chaque étape. En PyTorch, ces valeurs viennent généralement d’un DataLoader, qui découpe le dataset et distribue les sous-ensembles au fil des itérations.
Reprenons le même problème avec 10 000 points tirés au hasard. et sont volontairement placés assez loin l’un de l’autre, pour que l’exemple reste lisible.
r1 = 0
r2 = 4
points = (r1 - r2) * torch.rand((10000, 2)) + r2
points[-1] = torch.tensor([3., 3.])
points[-2] = torch.tensor([1., 1.])
points_a = torch.tensor([3., 3.])
points_b = torch.tensor([1., 1.])
a = ltn.Constant(torch.tensor([3., 3.]))
b = ltn.Constant(torch.tensor([1., 1.]))

fig, ax = plt.subplots()
ax.set_xlim(0, 4)
ax.set_ylim(0, 4)
ax.scatter(points[:,0], points[:,1], color="black", label="unknown")
ax.scatter(points_a[0], points_a[1], color="blue", label="a")
ax.scatter(points_b[0], points_b[1], color="red", label="b")
ax.set_title("Dataset of individuals")
plt.legend();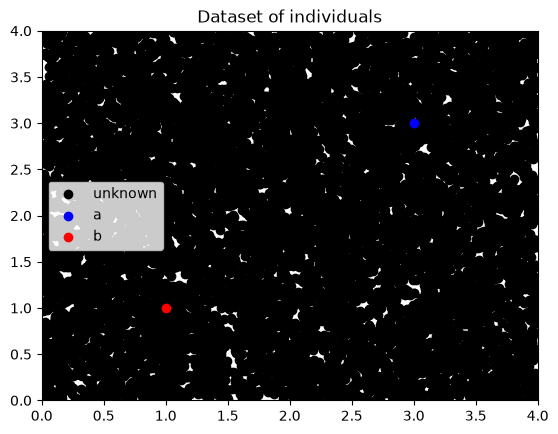
On définit un chargeur de données qui renvoie un batch de points à chaque itération, avec une taille de batch et un mélange optionnel à chaque epoch. Le principe de l’entraînement reste identique : les trois mêmes formules, agrégées par SatAgg, puis la rétropropagation. La seule différence est que et contiennent maintenant 512 points différents à chaque itération.
# on redéfinit C pour réinitialiser ses poids
C = ltn.Predicate(ModelC())

# chargeur de données qui crée les batchs
class DataLoader:
    def __init__(self,
                 dataset,
                 batch_size=1,
                 shuffle=True):
        self.data = dataset
        self.batch_size = batch_size
        self.shuffle = shuffle

    def __len__(self):
        return int(np.ceil(self.data.shape[0] / self.batch_size))

    def __iter__(self):
        n = self.data.shape[0]
        idxlist = list(range(n))
        if self.shuffle:
            np.random.shuffle(idxlist)

        for _, start_idx in enumerate(range(0, n, self.batch_size)):
            end_idx = min(start_idx + self.batch_size, n)
            batch_points = self.data[idxlist[start_idx:end_idx]]

            yield batch_points

train_loader = DataLoader(points, 512)

sat_agg = ltn.fuzzy_ops.SatAgg()
optimizer = torch.optim.Adam(C.parameters(), lr=0.001)

for epoch in range(100):
    for (batch_idx, (batch_points)) in enumerate(train_loader):
        x1 = ltn.Variable("x1", batch_points)  # on regrounde les variables
        x2 = ltn.Variable("x2", batch_points)  # avec le batch courant
        optimizer.zero_grad()
        loss = 1. - sat_agg(
            C(a, l_a),
            C(b, l_b),
            Forall([x1, x2, l], Implies(Sim(x1, x2), Equiv(C(x1, l), C(x2, l))))
        )
        loss.backward()
        optimizer.step()
    if epoch%10 == 0:
        print("Epoch %d: Sat Level %.3f "%(epoch, 1 - loss.item()))

print("Training finished at Epoch %d with Sat Level %.3f" %(epoch, 1 - loss.item()))
Epoch 0: Sat Level 0.670
Epoch 10: Sat Level 0.890
Epoch 20: Sat Level 0.943
Epoch 30: Sat Level 0.947
Epoch 40: Sat Level 0.948
Epoch 50: Sat Level 0.953
Epoch 60: Sat Level 0.946
Epoch 70: Sat Level 0.948
Epoch 80: Sat Level 0.952
Epoch 90: Sat Level 0.951
Training finished at Epoch 99 with Sat Level 0.951Après une vingtaine d’epochs, la satisfaction dépasse déjà 0.94, malgré la taille du dataset et le fait de ne voir que des mini-batchs. Elle oscille ensuite légèrement, puisque chaque batch est différent. Affichons les mêmes graphiques sur les 10 000 points :
x1 = ltn.Variable("x1", points)
x2 = ltn.Variable("x2", points)
fig = plt.figure(figsize=(10, 3))
fig.add_subplot(1, 2, 1)
plt.scatter(x1.value[:, 0], x1.value[:, 1], c=C(x1, l_a).value.detach().numpy(), vmin=0, vmax=1)
plt.title("C(x,l_a)")
plt.colorbar()
fig.add_subplot(1, 2, 2)
plt.scatter(x1.value[:, 0], x1.value[:, 1], c=C(x1, l_b).value.detach().numpy(), vmin=0, vmax=1)
plt.title("C(x,l_b)")
plt.colorbar()
plt.show();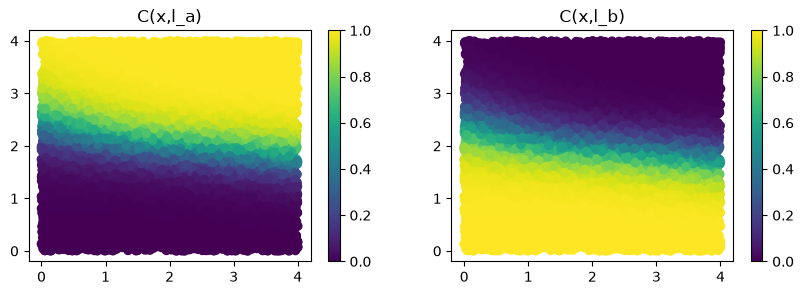
LTN a bien appris à séparer les deux classes. Les points de la bande centrale restent plus difficiles à classer, ce qui est cohérent avec l’intuition : leur distance à et à est comparable, et LTN n’a alors aucune information de proximité claire pour trancher.
À retenir
- Une base de connaissances est un ensemble de formules closes ; l’apprendre, c’est trouver les paramètres qui maximisent leur satisfaction.
SatAggagrège la satisfaction des formules en une seule valeur, et la perte vaut .- Seuls les poids des prédicats, fonctions et constantes apprenables changent ; la structure logique reste fixe.
- Des connaissances a priori, comme « deux points proches ont la même classe », permettent d’apprendre avec très peu d’étiquettes, parce que l’information se propage à travers toutes les paires.
- Travailler par mini-batchs revient simplement à regrounder les variables à chaque itération.
Cette partie clôt la présentation des mécanismes de LTN. Le même principe, des connaissances logiques transformées en fonction de perte, permet d’aller beaucoup plus loin : dans l’étude de cas de la partie 5, un LTN apprend à reconnaître des chiffres manuscrits sans jamais voir leur étiquette, à partir de la seule somme de deux chiffres.
Le notebook complet de cette partie est disponible dans mon dépôt.
Notes de la semaine
Chaque dimanche, je partage ce que j'ai appris : articles de recherche, idées, expériences et questions qui me sont restées en tête.
Vous pouvez vous désabonner à tout moment en un clic.
Discussion sur cet article0
Rejoindre la discussion
A secure sign-in link will be sent to your email address.
Chargement de la discussion...