Dans la partie 1, on a vu comment LTN ancre les symboles non logiques (constantes, variables, fonctions et prédicats) dans des tenseurs. Il reste la partie logique du langage : les connecteurs (, , , ) et les quantificateurs (, ). C’est elle qui permet d’assembler des prédicats en formules complètes, et d’obtenir pour chaque formule un seul degré de vérité.
Les connecteurs
Les connecteurs classiques ne peuvent pas être utilisés tels quels en LTN : leurs tables de vérité ne sont définies que pour des valeurs dans , alors que les prédicats LTN renvoient des degrés de vérité dans tout l’intervalle . LTN les remplace donc par des opérateurs de logique floue, définis sur tout l’intervalle continu.
Il existe plusieurs familles d’opérateurs flous valides (Gödel, produit, Łukasiewicz), mais elles ne se valent pas pour l’entraînement. Le / de Gödel, par exemple, ne fait circuler le gradient que vers un seul de ses arguments à la fois, ce qui peut ralentir, voire bloquer, l’apprentissage. LTN recommande en général la configuration suivante, où et sont deux degrés de vérité dans :
| Connecteur | Opérateur flou | Formule |
|---|---|---|
| négation standard | ||
| t-norme produit | ||
| t-conorme produit (somme probabiliste) | ||
| implication de Reichenbach |
Ce choix n’a rien d’arbitraire. Contrairement au /, le produit répartit le gradient sur ses deux arguments à la fois, ce qui le rend plus stable numériquement. Ce compromis entre fidélité logique et comportement du gradient fera l’objet de la partie 3.
On remarque d’ailleurs que ces formules retrouvent les tables de vérité classiques sur les valeurs extrêmes : avec et , l’implication vaut , comme « vrai implique faux ». Entre les deux, elles varient continûment.
En LTN, un connecteur se crée avec le constructeur Connective(), qui prend une sémantique floue choisie dans le module ltn.fuzzy_ops :
import ltn
import torch

Not = ltn.Connective(ltn.fuzzy_ops.NotStandard())
And = ltn.Connective(ltn.fuzzy_ops.AndProd())
Or = ltn.Connective(ltn.fuzzy_ops.OrProbSum())
Implies = ltn.Connective(ltn.fuzzy_ops.ImpliesReichenbach())
Le broadcasting
Le wrapper ltn.Connective ne se contente pas d’appliquer la formule floue. Il gère aussi la combinaison de sous-formules qui ne portent pas sur les mêmes variables. On l’a vu dans la partie 1 : une formule sur seul a la forme , une formule sur et a la forme . Avant d’appliquer l’opérateur terme à terme, le connecteur doit donc étendre ces formes pour les rendre compatibles. C’est le broadcasting.
Pour l’observer, on définit deux variables de tailles différentes, deux constantes, et un prédicat de similarité : la même construction que dans la partie 1, qui vaut 1 quand les deux points coïncident et tend vers 0 quand ils s’éloignent.
x = ltn.Variable('x', torch.randn((10, 2)))  # 10 points de R^2
y = ltn.Variable('y', torch.randn((5, 2)))   # 5 points de R^2

c1 = ltn.Constant(torch.tensor([0.5, 0.0]))
c2 = ltn.Constant(torch.tensor([4.0, 2.0]))

Eq = ltn.Predicate(func=lambda x, y: torch.exp(-torch.norm(x - y, dim=1)))

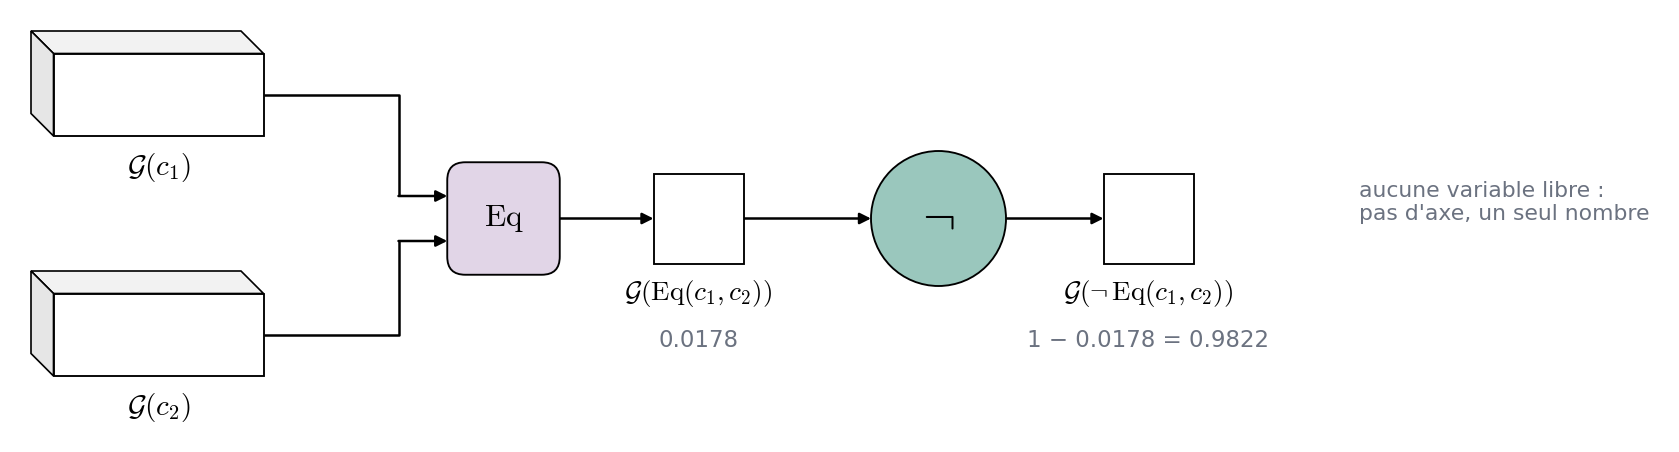
Eq(c1, c2).valuetensor(0.0178)et sont éloignés, donc leur similarité est proche de 0. Voyons maintenant les connecteurs sur des cas concrets :
Not(Eq(c1, c2)).valuetensor(0.9822)On retrouve bien .
Implies(Eq(c1, c2), Eq(c2, c1)).valuetensor(0.9825)Avec , l’implication de Reichenbach donne : une prémisse presque fausse rend l’implication presque vraie, comme en logique classique.
Les deux exemples suivants sont les plus instructifs, car ils montrent deux situations différentes vis-à-vis des variables.
And(Eq(x, c1), Eq(x, c2)).shape()torch.Size([10])Dans And(Eq(x, c1), Eq(x, c2)), seule la variable apparaît dans les deux sous-formules. Les deux résultats ont déjà la même forme , donc aucun broadcasting n’est nécessaire : And les combine directement, individu par individu.
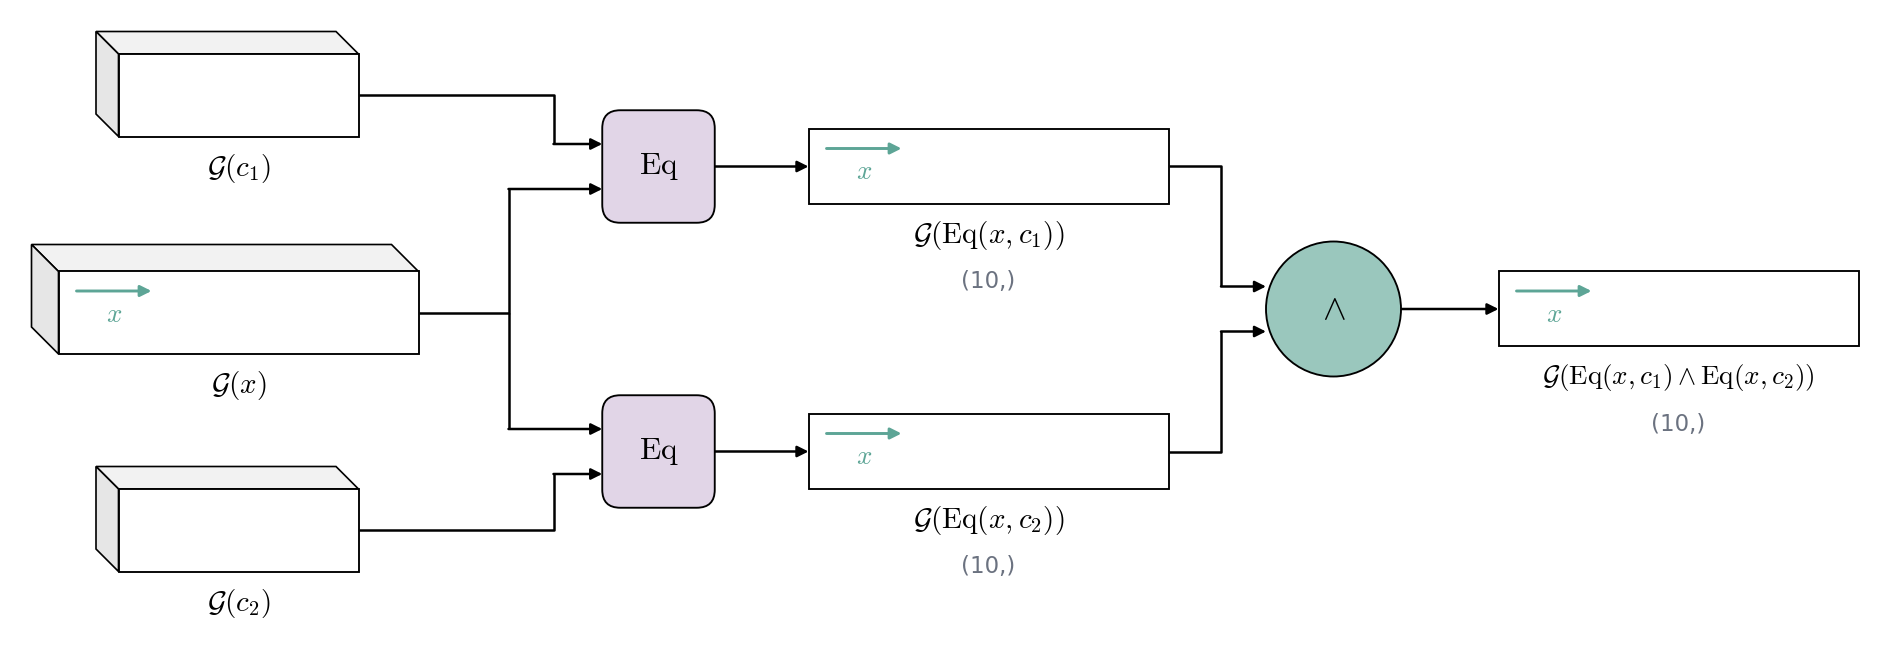
And appliqué à deux sous-formules qui ne dépendent que de : elles ont déjà la même forme , et la conjonction les combine individu par individu, sans broadcasting.Or(Eq(x, c1), Eq(x, y)).shape()torch.Size([10, 5])Dans Or(Eq(x, c1), Eq(x, y)), la situation est différente. Eq(x, c1) ne dépend que de et a la forme , tandis que Eq(x, y) dépend de et de et a la forme : une évaluation sur deux variables produit toutes les combinaisons. Le connecteur détecte cet écart et étend le premier résultat le long de l’axe manquant, celui de , en répétant chaque valeur pour les 5 individus de . Il applique ensuite Or terme à terme, d’où la forme finale .
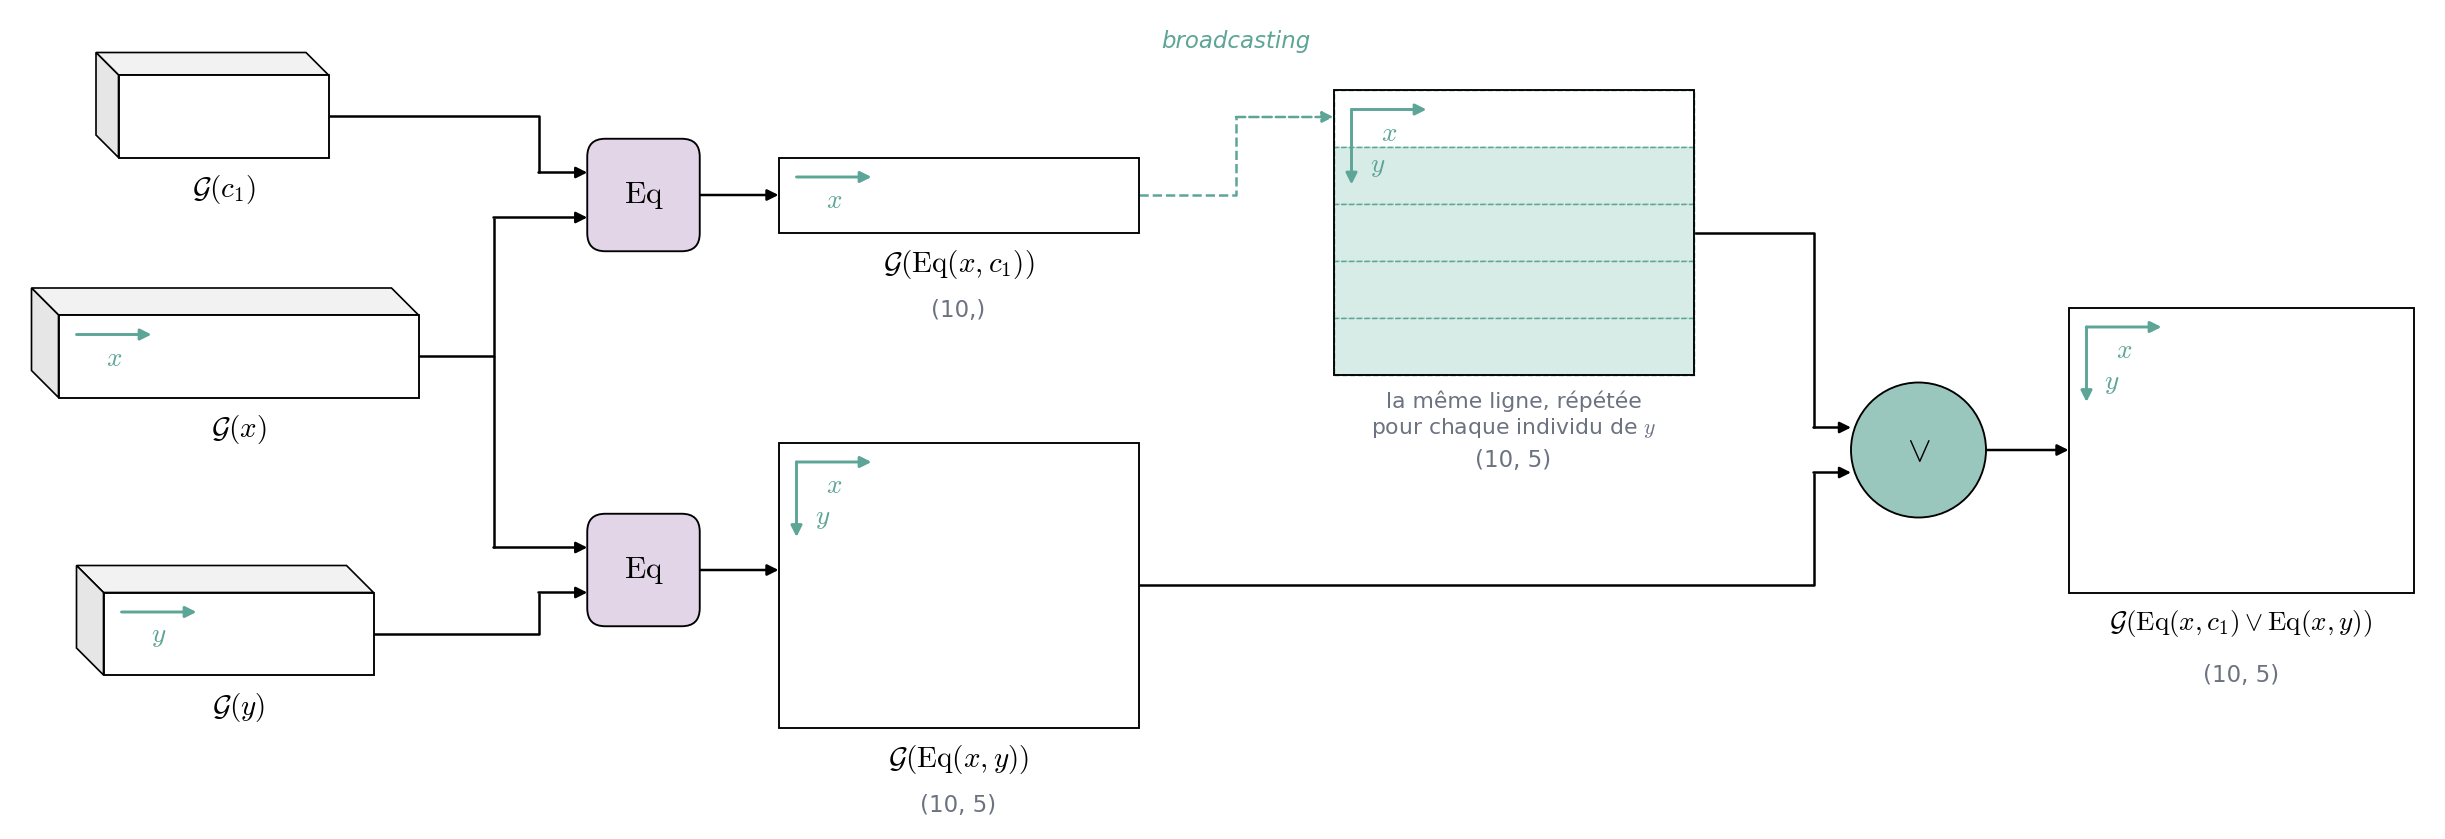
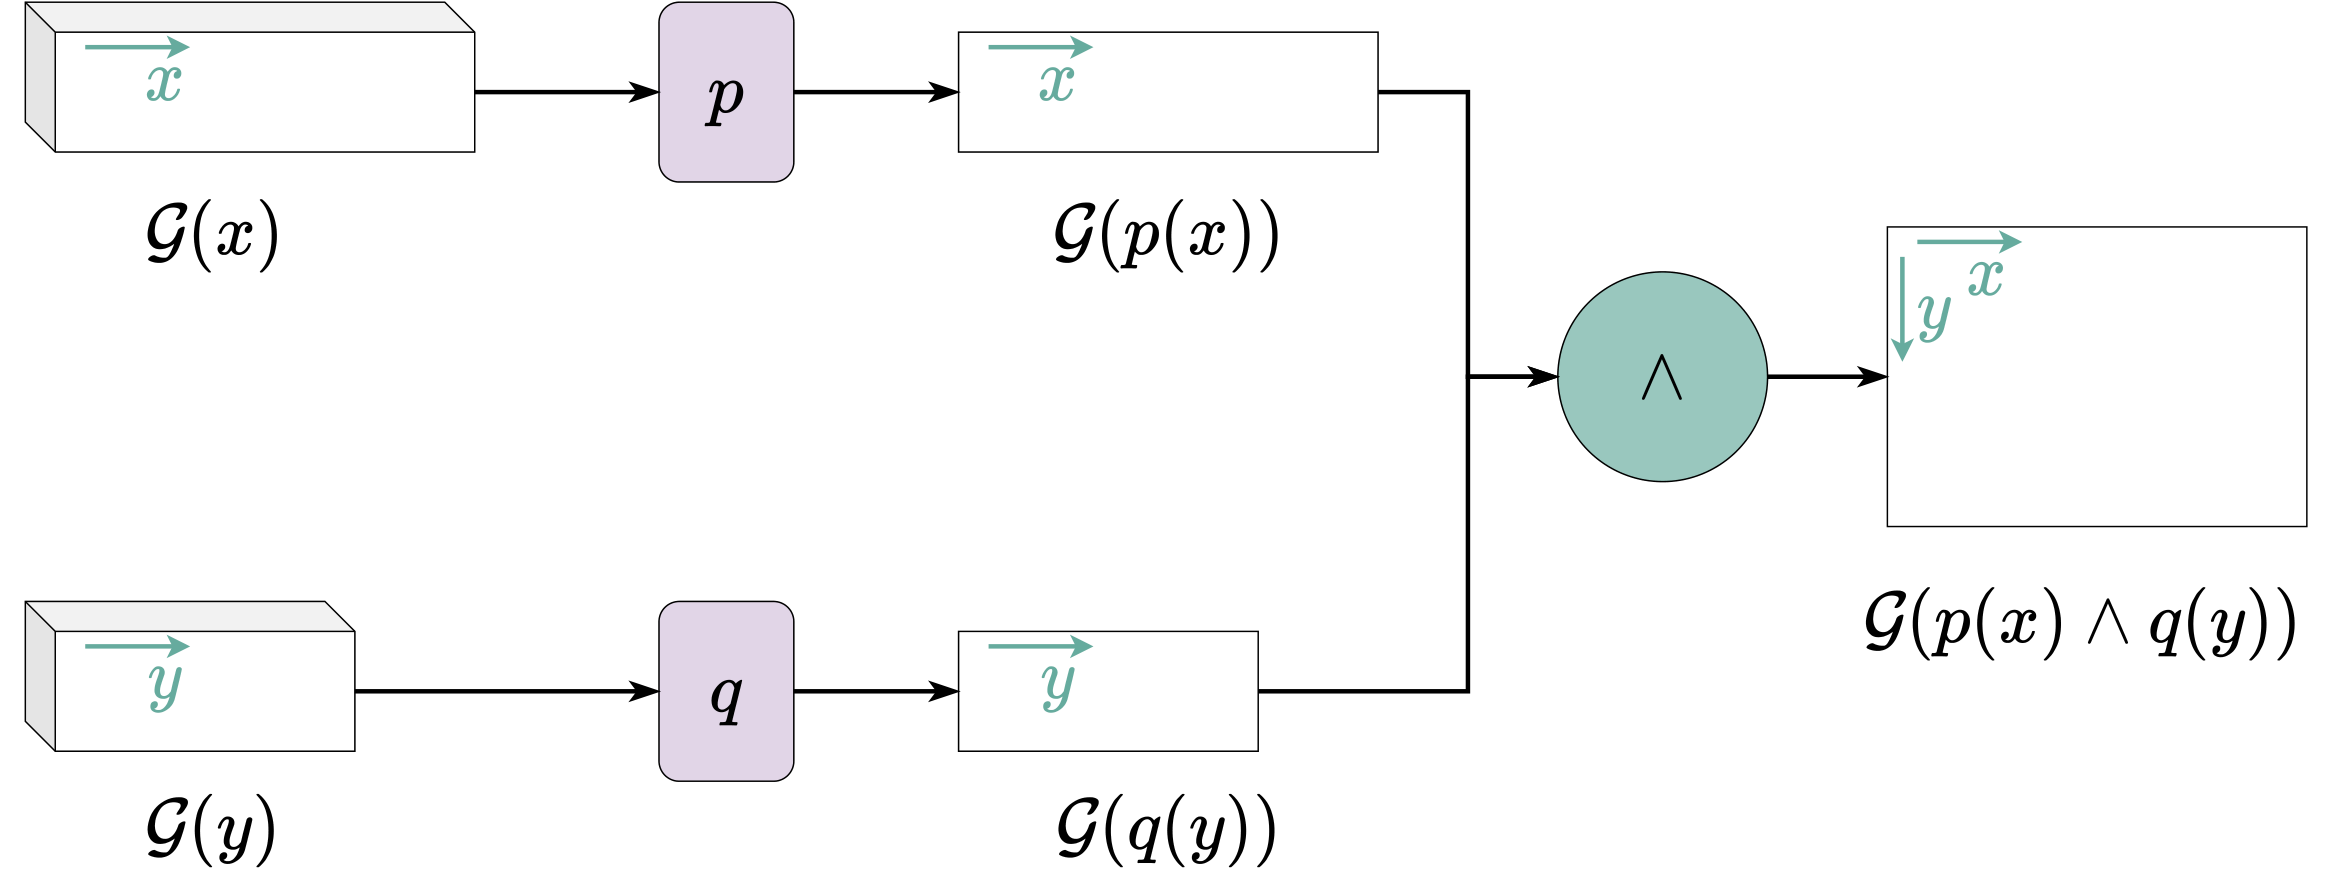
Or appliqué à , de forme , et à , de forme : le premier résultat est d’abord recopié le long de l’axe de , puis la disjonction est appliquée case par case.La figure de l’article montre le même mécanisme dans le cas général de deux sous-formules qui portent chacune sur une variable différente :
Comme les prédicats et les fonctions, les connecteurs renvoient des LTNObject : on lit le résultat avec .value et sa forme avec shape().
Les quantificateurs
Les quantificateurs ne peuvent pas non plus être utilisés sous leur forme classique. et supposent de vérifier une propriété sur un domaine entier, alors qu’en LTN une variable ne représente qu’un batch fini d’individus, avec des degrés de vérité continus. LTN les remplace donc par des opérateurs d’agrégation, qui condensent les degrés de vérité d’un batch en une seule valeur.
Pour une liste de degrés de vérité dans , les deux opérateurs recommandés sont :
- pour , la moyenne généralisée (
pMean) :
- pour , la moyenne généralisée des écarts à la vérité (
pMeanError) :
Ces formules ne sont pas choisies au hasard : pMean approxime le maximum et pMeanError le minimum. C’est bien l’esprit de , pour lequel il suffit qu’un seul individu satisfasse la propriété, et de , pour lequel c’est le pire cas qui compte. On le démontrera un peu plus loin.
Un quantificateur se crée avec le constructeur Quantifier(), qui prend une sémantique d’agrégation et le type de quantification : "e" pour l’existentielle, "f" pour l’universelle.
Forall = ltn.Quantifier(ltn.fuzzy_ops.AggregPMeanError(p=2), quantifier="f")
Exists = ltn.Quantifier(ltn.fuzzy_ops.AggregPMean(p=2), quantifier="e")
Quantifier, c’est agréger le long d’un axe
Le wrapper ltn.Quantifier choisit lui-même les dimensions à agréger d’après les variables qu’on lui passe. Quantifier sur une variable revient à appliquer l’agrégateur le long de l’axe de cette variable, ce qui fait disparaître cet axe du résultat. C’est là que les labels des variables, vus dans la partie 1, prennent tout leur sens.
x = ltn.Variable('x', torch.randn((10, 2)))  # 10 points de R^2
y = ltn.Variable('y', torch.randn((5, 2)))   # 5 points de R^2

Eq = ltn.Predicate(func=lambda x, y: torch.exp(-torch.norm(x - y, dim=1)))

Eq(x, y).shape()
torch.Size([10, 5])Quantifions sur seul :
Forall(x, Eq(x, y)).shape()torch.Size([5])L’axe de a disparu, il ne reste que celui de . Le résultat est encore une fonction de : pour chacun des 5 individus de , il indique à quel degré la propriété est vraie pour tous les .
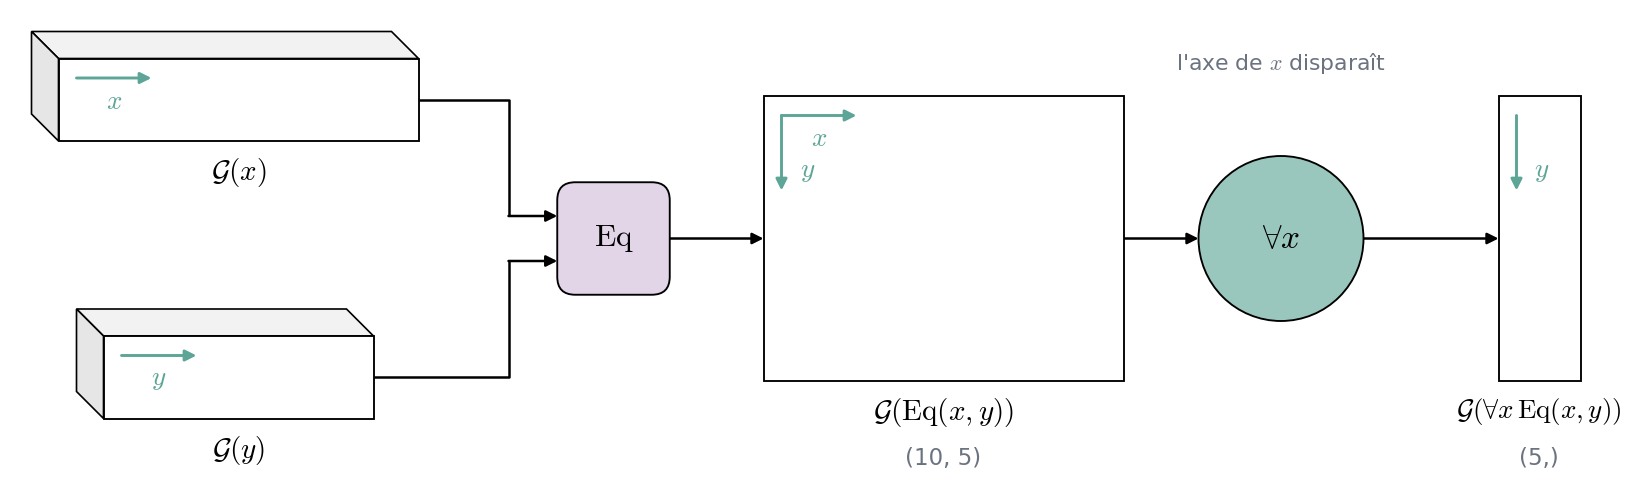
Quand la quantification porte sur les deux variables, les deux axes disparaissent et on obtient un scalaire, un seul degré de satisfaction pour toute la formule :
Forall([x, y], Eq(x, y)).valuetensor(0.1521)Exists([x, y], Eq(x, y)).valuetensor(0.2211)Forall(x, Exists(y, Eq(x, y))).valuetensor(0.1846)Le dernier exemple imbrique deux quantificateurs : « pour tout , il existe un similaire ». Exists(y, …) fait d’abord disparaître l’axe de et laisse un vecteur de forme , que Forall(x, …) réduit ensuite à un scalaire.
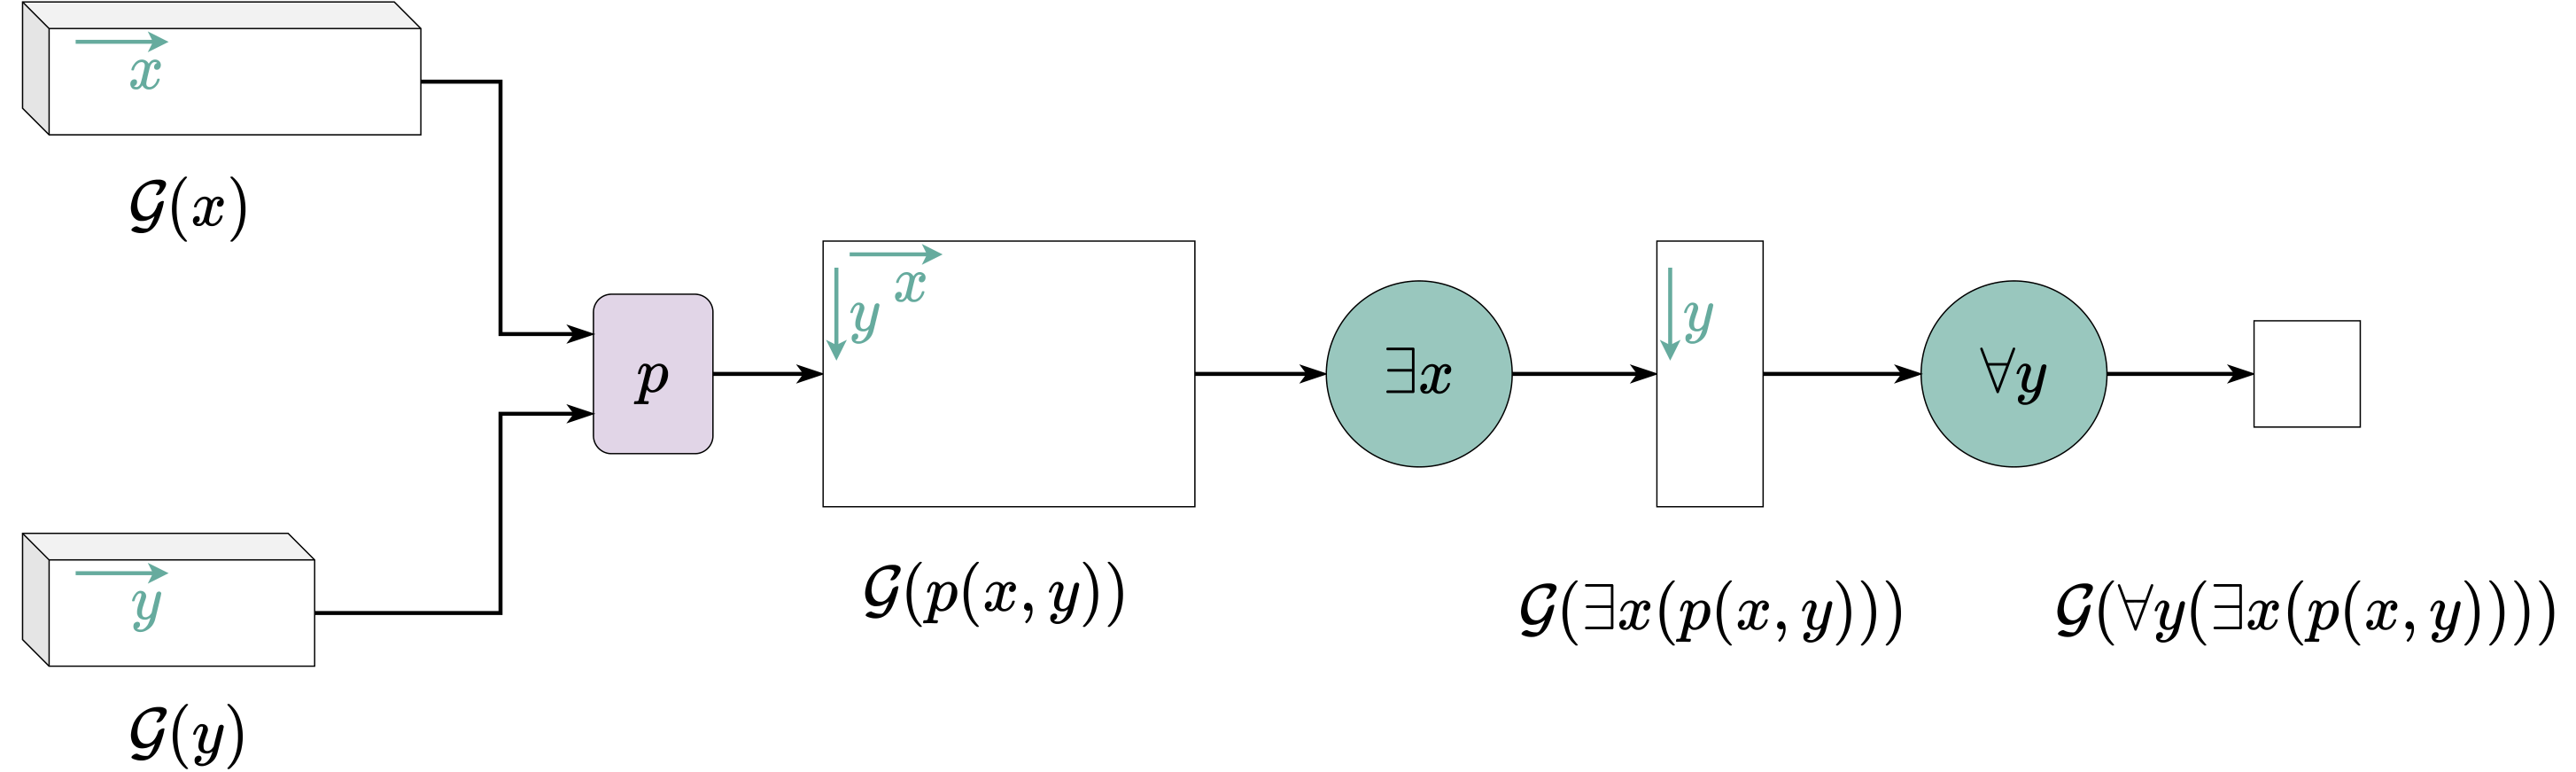
Un point de syntaxe à retenir : une seule variable se passe directement au quantificateur, plusieurs variables doivent être regroupées dans une liste, comme [x, y].
Pourquoi pMean tend vers le maximum, et pMeanError vers le minimum
On a annoncé que pMean approxime le maximum et pMeanError le minimum. Démontrons-le.
pMean tend vers le maximum. On veut montrer que, pour :
Notons . Le cas est trivial (tous les sont nuls et pMean vaut 0) ; on suppose donc , ce qui permet de factoriser :
Posons , qui est dans puisque . Deux cas se présentent :
- pour un indice qui réalise le maximum, , donc pour tout ;
- pour tout autre indice, , et un nombre strictement inférieur à 1 élevé à une puissance qui grandit indéfiniment tend vers 0.
En notant le nombre d’indices qui réalisent le maximum (en général , mais des égalités restent possibles) :
Reste la racine -ième. Comme est une constante strictement positive, on utilise le résultat classique pour tout : il suffit d’écrire et de remarquer que . D’où :
pMeanError tend vers le minimum. On veut montrer que :
L’astuce consiste à appliquer le résultat précédent non pas aux , mais à leurs compléments , qui sont eux aussi dans :
Or .
Justification
Soit . Pour tout , , donc : majore la famille, et .
Le minimum d’une famille finie est atteint : il existe tel que , donc est l’un des termes de la famille. Le maximum étant supérieur ou égal à chaque terme, .
Les deux inégalités donnent l’égalité.
On en déduit :
Le rôle de p
pMean est donc un maximum adouci : pour , c’est une simple moyenne, et quand , elle tend vers le maximum strict. De même, pMeanError est un minimum adouci, qui va de la moyenne () au minimum strict ().
Le paramètre règle en fait un compromis entre fidélité logique et tolérance aux cas difficiles du batch.
Quand est élevé, pMeanError se rapproche du vrai minimum, et retrouve son sens strict : un seul individu avec un faible degré de vérité suffit à faire chuter le résultat, comme on l’attend d’un « pour tout » rigoureux. C’est fidèle, mais exigeant : pour obtenir un score élevé, tous les individus sans exception doivent avoir un degré de vérité élevé. Symétriquement, pMean se rapproche du vrai maximum, et redevient facile à satisfaire : un seul bon individu suffit.
Quand se rapproche de 1, les deux opérateurs se rapprochent d’une moyenne où chaque individu pèse à peu près autant. Les cas extrêmes cessent alors de dominer : un très mauvais individu peut être compensé par plusieurs bons, et inversement. Cette compensation rend plus tolérant (un individu défaillant ne suffit plus à tout faire chuter) et plus exigeant (un seul bon individu ne suffit plus). C’est un écart volontaire par rapport à la sémantique logique stricte, utile en pratique pour absorber le bruit dans les données ou pour mieux répartir le gradient à l’entraînement.
Le choix de dépend donc de l’objectif : un élevé pour une formule qui doit rester stricte et ne tolérer aucune exception, un proche de 1 pour une formule robuste aux données bruitées ou aux valeurs aberrantes. Ce choix a aussi des conséquences importantes sur l’entraînement, qu’on verra dans la partie 3.
On peut fixer à la création de l’opérateur, ou le changer à chaque appel :
Forall(x, Eq(x, c1), p=2).valuetensor(0.1942)Forall(x, Eq(x, c1), p=10).valuetensor(0.1232)Exists(x, Eq(x, c1), p=2).valuetensor(0.3085)Exists(x, Eq(x, c1), p=10).valuetensor(0.6013)Quand passe de 2 à 10, baisse (de 0.19 à 0.12) parce qu’il se rapproche du pire individu, et monte (de 0.31 à 0.60) parce qu’il se rapproche du meilleur.
La quantification diagonale
Jusqu’ici, évaluer un prédicat sur deux variables produisait toujours toutes les combinaisons de leurs individus. Ce n’est pas toujours ce qu’on veut. Dans un dataset supervisé, chaque donnée a son propre label : on veut évaluer le prédicat sur les paires , , etc., jamais sur des combinaisons croisées comme , qui n’ont aucun sens.
C’est ce que permet ltn.diag : au lieu de croiser toutes les combinaisons, il ne garde que les paires en correspondance un à un, comme un zip en Python plutôt que deux boucles imbriquées. Cela impose que les variables aient le même nombre d’individus.
Prenons l’exemple suivant :
- la variable contient 100 individus dans ;
- la variable contient les 100 labels correspondants, encodés en one-hot (3 classes) ;
- chaque paire est un exemple du dataset ;
- le classifieur renvoie un degré de confiance dans que l’échantillon corresponde au label .
# Valeurs aléatoires pour l'illustration ; en pratique, elles viendraient d'un dataset
samples = torch.randn((100, 2, 2))         # 100 valeurs de R^{2x2}
labels = torch.randint(0, 3, size=(100,))  # le label (classe 0, 1 ou 2) de chaque échantillon
onehot_labels = torch.nn.functional.one_hot(labels, num_classes=3)

x = ltn.Variable("x", samples)
l = ltn.Variable("l", onehot_labels)

class ModelC(torch.nn.Module):
    def __init__(self):
        super().__init__()
        self.elu = torch.nn.ELU()
        self.softmax = torch.nn.Softmax(dim=1)
        self.dense1 = torch.nn.Linear(4, 5)
        self.dense2 = torch.nn.Linear(5, 3)

    def forward(self, x, l):
        x = torch.flatten(x, start_dim=1)   # la matrice 2 x 2 devient un vecteur de taille 4
        x = self.elu(self.dense1(x))
        x = self.softmax(self.dense2(x))    # une probabilité par classe
        return torch.sum(x * l, dim=1)      # on garde la probabilité de la classe l

C = ltn.Predicate(ModelC())
La dernière ligne du forward mérite une explication. Si le réseau sort pour un échantillon dont le label est , le produit terme à terme suivi de la somme donne : la probabilité que le réseau attribue à la bonne classe.
Sans ltn.diag, C(x, l) évalue les combinaisons. Réduisons l’exemple à 4 individus pour voir le problème : sur les 16 paires produites, seules les 4 de la diagonale, à , correspondent à de vrais exemples. Toutes les autres posent une question qu’on n’a jamais voulu poser, comme « l’échantillon a-t-il le label de l’exemple 1 ? ».
ltn.diag(x, l) ne garde que les 100 paires correspondantes : la forme du résultat passe de à .
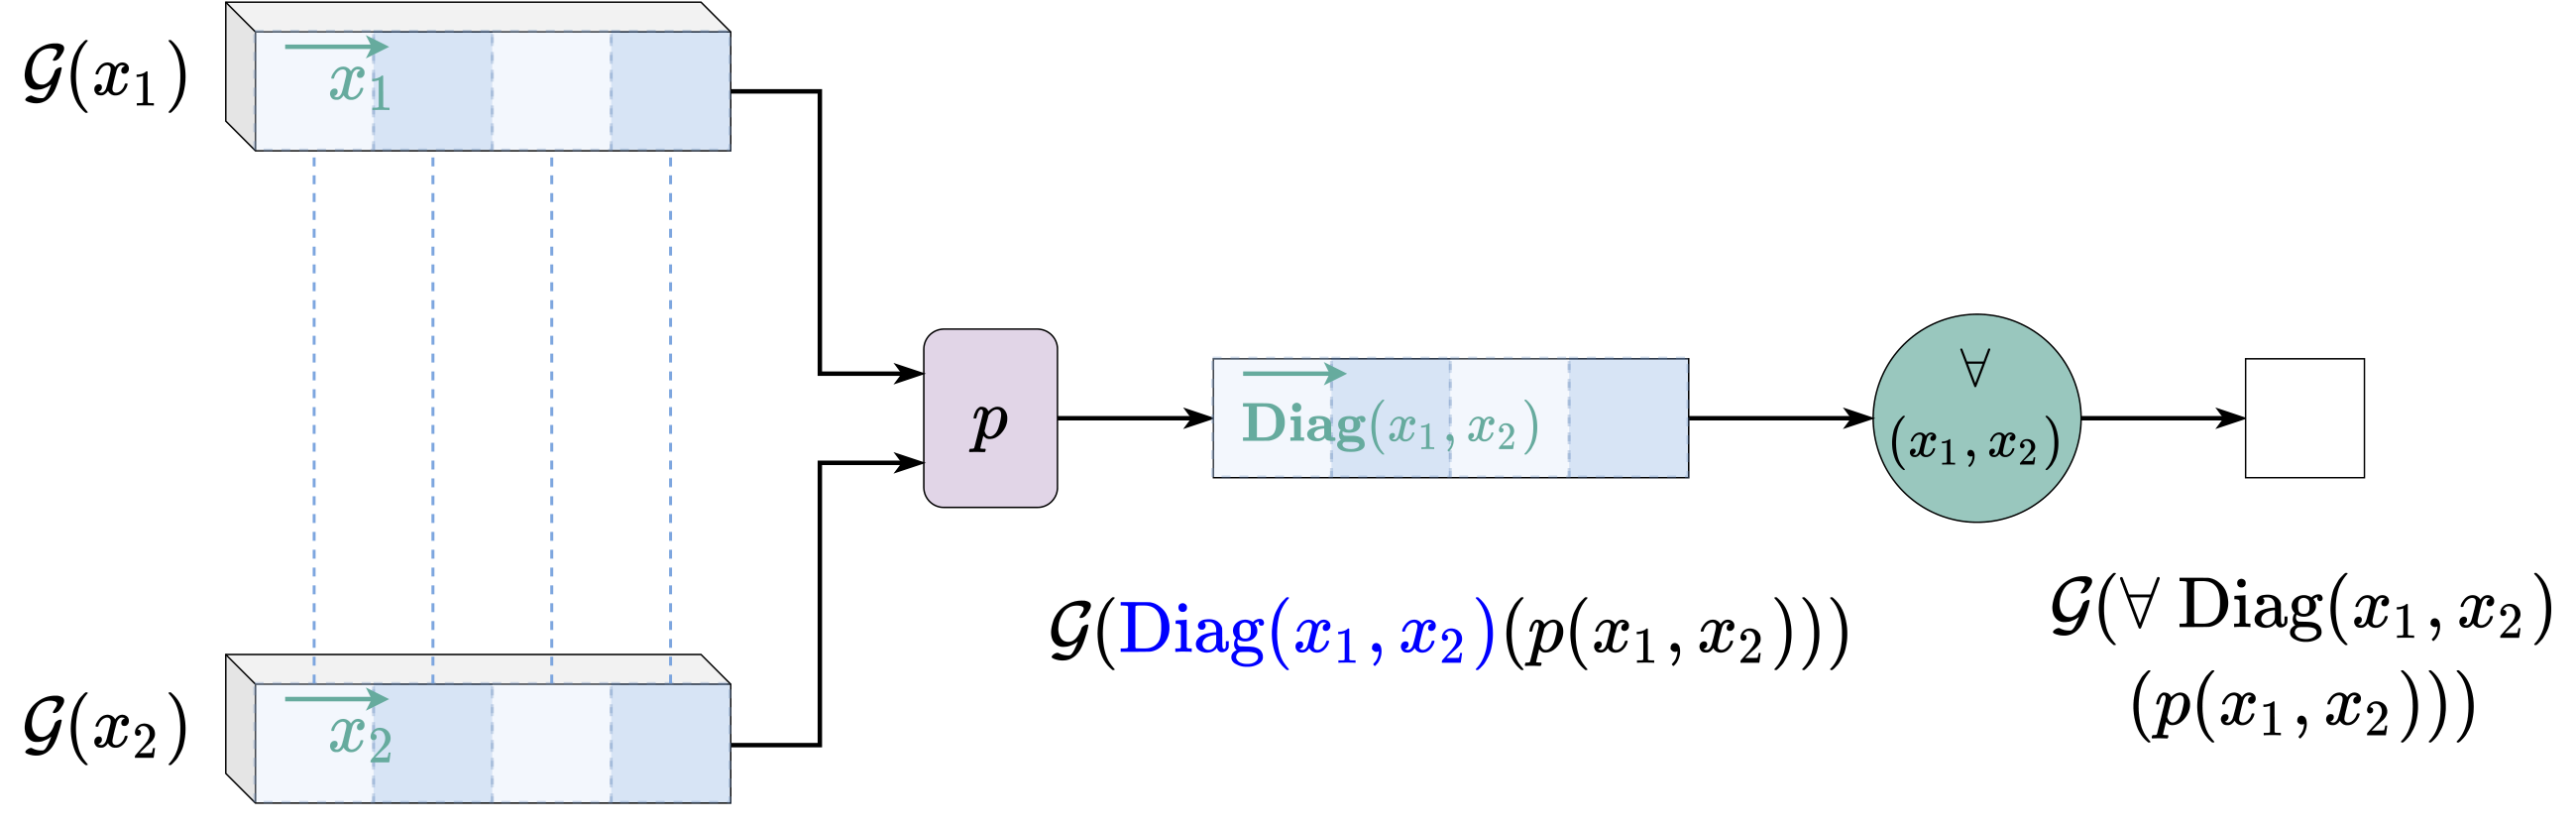
Le mécanisme repose une fois de plus sur les labels des variables : ltn.diag donne temporairement à et le même label, préfixé par diag_. Comme LTN se base sur les labels pour décider si deux variables sont croisées ou parcourues ensemble, partager le même label suffit à passer du croisement complet à la correspondance un à un. ltn.undiag restaure les labels d’origine.
print(C(x, l).shape())  # les 100 x 100 combinaisons
ltn.diag(x, l)          # active la correspondance un à un
print(C(x, l).shape())  # les 100 paires correspondantes
print(x.free_vars)
print(l.free_vars)
ltn.undiag(x, l)        # rétablit le comportement normal
print(C(x, l).shape())  # de nouveau les 100 x 100 combinaisons
torch.Size([100, 100])
torch.Size([100])
['diag_x_l']
['diag_x_l']
torch.Size([100, 100])En pratique, ltn.diag s’utilise juste avant un quantificateur. Chaque quantificateur appelle automatiquement ltn.undiag une fois l’agrégation faite, si bien que les variables retrouvent leur comportement normal en dehors de la formule.
x, l = ltn.diag(x, l)
print(x.free_vars)
print(l.free_vars)
print(Forall([x, l], C(x, l)).value)  # agrège seulement sur les 100 paires correspondantes
print(x.free_vars)                    # undiag a été appelé automatiquement
print(l.free_vars)
['diag_x_l']
['diag_x_l']
tensor(0.3384, grad_fn=<RsubBackward1>)
['x']
['l']pose exactement la question d’un problème de classification supervisée : à quel degré le modèle attribue-t-il une bonne confiance à chaque exemple associé à son vrai label ? Le réseau n’étant pas entraîné, le score est faible.
Les quantificateurs gardés
On veut parfois quantifier non pas sur tous les individus d’une variable, mais seulement sur ceux qui satisfont une condition. Cette condition n’est pas un degré de vérité continu comme un prédicat LTN : c’est un masque booléen, strictement 0 ou 1, qui sert uniquement à choisir quels individus participent à l’agrégation.
Soit une fonction de masquage qui renvoie un booléen pour chaque élément du domaine. On peut alors écrire :
- : « tout qui satisfait satisfait aussi » ;
- : « il existe un qui satisfait et qui satisfait aussi ».
Le masque peut dépendre d’autres variables de la formule : est un énoncé valide, où la condition sur dépend de .
Prenons un exemple qui affirme qu’il existe une distance en dessous de laquelle toutes les paires de points sont similaires :
est le prédicat de similarité déjà utilisé, et calcule la distance euclidienne entre deux points.
Eq = ltn.Predicate(func=lambda x, y: torch.exp(-torch.norm(x - y, dim=1)))

points = torch.rand((50, 2))  # 50 points de [0,1]^2
x = ltn.Variable("x", points)
y = ltn.Variable("y", points)
d = ltn.Variable("d", torch.tensor([.1, .2, .3, .4, .5, .6, .7, .8, .9]))
Un quantificateur gardé prend deux arguments supplémentaires : cond_vars, la liste des variables dont dépend la condition, et cond_fn, la fonction qui calcule le masque à partir de ces variables.
dist = lambda x, y: torch.unsqueeze(torch.norm(x.value - y.value, dim=1), 1)

Exists(d,
      Forall([x, y],
            Eq(x, y),
            cond_vars=[x, y, d],
            cond_fn=lambda x, y, d: dist(x, y) < d.value
            )).value
tensor(0.7599, dtype=torch.float64)Ici, cond_vars=[x, y, d] indique que la condition dépend de , et , et cond_fn teste, pour chaque combinaison, si la distance entre et est inférieure au seuil . LTN calcule sur toutes les combinaisons, calcule le masque en parallèle, puis n’agrège que les valeurs pour lesquelles le masque est vrai. Les paires trop éloignées sont simplement exclues.
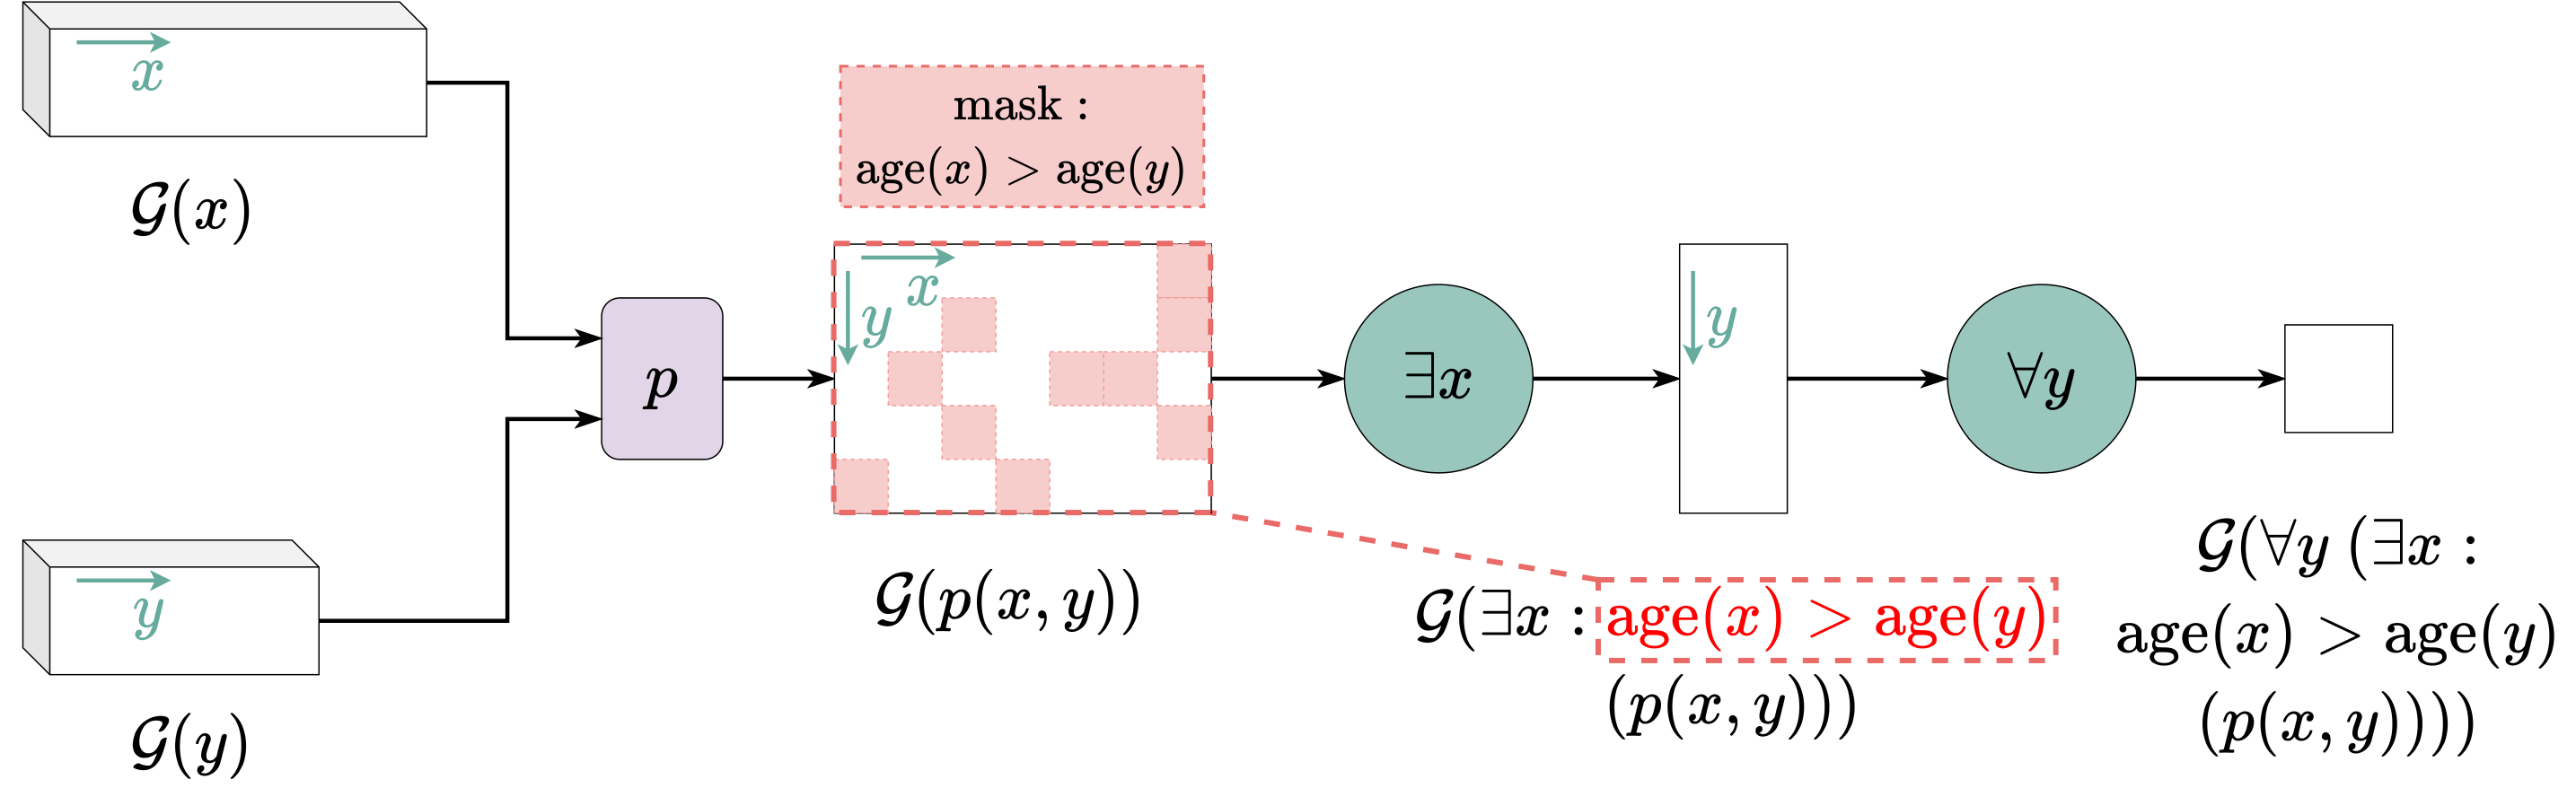
C’est particulièrement utile pour l’apprentissage : le gradient ne se propage alors que sur la partie du domaine qui vérifie la condition, au lieu de se diluer sur des combinaisons qui n’ont aucun sens pour la règle.
À retenir
- Les connecteurs deviennent des opérateurs flous différentiables. La configuration recommandée : négation standard, produit, somme probabiliste et implication de Reichenbach.
- Un connecteur broadcaste automatiquement des sous-formules qui ne portent pas sur les mêmes variables.
- Les quantificateurs deviennent des agrégations le long de l’axe de la variable quantifiée :
pMeanErrorpour , un minimum adouci, etpMeanpour , un maximum adouci. - Le paramètre règle le compromis entre fidélité logique (grand ) et tolérance au bruit (petit ).
ltn.diagremplace le croisement complet par une correspondance un à un, indispensable pour les paires (donnée, label).- Les quantificateurs gardés restreignent l’agrégation aux individus qui satisfont un masque booléen.
On sait maintenant évaluer n’importe quelle formule. Mais pour qu’un réseau apprenne à satisfaire ces formules, il faut que leur gradient se comporte bien, et ce n’est pas le cas pour tous les opérateurs. Dans la partie 3, on verra les pièges du gradient et la configuration « produit stable » qui permet de les éviter.
Le notebook complet de cette partie est disponible dans mon dépôt.
Notes de la semaine
Chaque dimanche, je partage ce que j'ai appris : articles de recherche, idées, expériences et questions qui me sont restées en tête.
Vous pouvez vous désabonner à tout moment en un clic.
Discussion sur cet article0
Rejoindre la discussion
A secure sign-in link will be sent to your email address.
Chargement de la discussion...