Introduction
La détection d’anomalies dans les séries temporelles multivariées consiste non seulement à déterminer si un comportement anormal s’est produit, mais aussi à identifier le moment où il apparaît et les variables qui en sont responsables. Cette localisation est particulièrement cruciale lorsque les données proviennent de multiples capteurs ou décrivent simultanément plusieurs sous-systèmes industriels ou physiques.
Cependant, disposer d’une étiquette globale indiquant qu’une séquence temporelle complète est anormale ne signifie pas que l’on connaît les instants précis ni les variables en cause. Obtenir ces annotations fines à l’échelle de chaque pas de temps et de chaque capteur exige un temps et des ressources considérables. L’apprentissage par sacs d’instances (Multiple Instance Learning, MIL) constitue une approche idéale pour surmonter ce verrou : le modèle est entraîné à partir de simples étiquettes globales au niveau de la séquence, tout en apprenant à détecter et localiser les anomalies au niveau des instances individuelles.
C’est dans ce contexte que Jang et Kwon ont proposé TAIL-MIL (Time-Aware and Instance-Learnable Multiple Instance Learning for Multivariate Time Series Anomaly Detection), une architecture conçue pour détecter les anomalies à plusieurs niveaux d’abstraction d’une série temporelle multivariée. Les auteurs modélisent les données selon une structure hiérarchique à deux dimensions : une fenêtre temporelle complète, appelée Time-Aware Bag (TAB), contient plusieurs instances temporelles (Time-Point Instances in Multivariate data, TPIM), chacune étant elle-même composée d’instances associées aux différentes variables (Variate Instances in TPIM, VI-TPIM).
L’objectif est de bâtir un modèle unifié capable à la fois de prédire si une fenêtre temporelle est anormale, de localiser les pas de temps concernés et d’isoler les variables incriminées. Pour y parvenir, les auteurs formulent trois objectifs de recherche :
- R1 — Modéliser les relations entre instances : le mécanisme d’attention doit prendre en compte les relations entre les VI-TPIM appartenant à des TPIM différents, afin d’exploiter pleinement les dépendances temporelles.
- R2 — Construire la prédiction globale à partir des prédictions individuelles : la prédiction globale du TAB doit s’appuyer directement sur les prédictions issues des instances de granularité fine. Cela permet d’unifier la détection globale et la localisation des anomalies.
- R3 — Préserver les caractéristiques locales : les prédictions individuelles doivent reposer sur les représentations originales extraites des instances, sans que celles-ci soient dénaturées ou lissées par l’injection d’informations contextuelles provenant d’autres instants.
Pour répondre à ces trois exigences, TAIL-MIL associe deux mécanismes d’attention complémentaires — T-Attention et V-Attention — couplés à une agrégation hiérarchique des prédictions.
Formulation hiérarchique du problème
Considérons une fenêtre temporelle (TAB) , où chaque représente le -ème TPIM (pas de temps).
Chaque TPIM est composé de variables (les VI-TPIM) :
où désigne la valeur de la variable au temps .
Le modèle doit apprendre conjointement trois niveaux de détection :
- Quelle cellule variable-temps est anormale ?
- Quel pas de temps est anormal ?
- La séquence globale (le TAB) est-elle anormale ?
La logique booléenne sous-jacente
Idéalement, la décision repose sur une double disjonction logique () :
-
Niveau VI-TPIM TPIM : Un pas de temps est anormal si au moins l’une de ses variables présente un comportement anormal :
Soit formellement : .
-
Niveau TPIM TAB : Une fenêtre temporelle est anormale si au moins un de ses pas de temps est anormal :
La chaîne de décision globale s’écrit donc :
Le défi de TAIL-MIL consiste à construire une version continue, différentiable et apprenable de cette cascade logique, guidée uniquement par une supervision au niveau du TAB.
Mécanismes d’attention : T-Attention et V-Attention
1. T-Attention (niveau temporel)
Le premier mécanisme d’attention opère entre les différents TPIM d’un même TAB (). Son rôle est de satisfaire l’objectif R1 : un instant doit pouvoir être évalué en relation avec l’ensemble du contexte temporel, et non de façon isolée.
Soit un TPIM . On commence par extraire sa représentation latente via un encodeur :
Pour l’ensemble de la fenêtre , la matrice des représentations s’écrit :
où est la dimension de l’espace latent et le nombre de pas de temps dans le TAB.
Deux projections apprenables sont alors introduites :
- Un vecteur : le produit produit un scalaire. condense chaque représentation -dimensionnelle en une valeur unique. Sur l’ensemble des TPIM, , et la fonction sigmoïde borne chaque score entre et .
- Une matrice : le produit projette chaque TPIM dans un espace à composantes. Sur l’ensemble du TAB, on obtient une matrice , dont chaque élément est borné entre et par .
Le score d’attention global est alors obtenu par la combinaison :
Remarque sur le scaling : Le facteur permet de stabiliser les amplitudes des produits scalaires et d’éviter la saturation du softmax quand la longueur de fenêtre grandit.
Pour mieux comprendre l’interaction, posons :
et
Pour le -ème pas de temps, le score intermédiaire avant normalisation vaut :
Chaque score dépend ainsi des contributions croisées de tous les autres TPIM (). Enfin, la fonction softmax produit les poids finaux normalisés :
Cette formulation permet à T-Attention de pondérer chaque pas de temps en fonction de ses corrélations temporelles.
2. V-Attention (niveau des variables)
T-Attention arbitre entre les pas de temps. V-Attention, quant à elle, opère à l’intérieur de chaque TPIM afin d’évaluer l’importance relative de chaque variable.
Dans les séries temporelles, l’état d’une variable à l’instant présent est souvent conditionné par son historique récent. Pour incorporer ce contexte sans altérer les caractéristiques intrinsèques nécessaires aux prédictions locales, V-Attention définit un champ récepteur temporel (Receptive Field, ) pour chaque variable :
Dans l’article de référence, les auteurs fixent , ce qui simplifie l’expression :
- Pour :
- Pour :
Considérons un TPIM composé de variables. Posons la représentation brute, et la représentation contextuelle. On construit alors les matrices correspondantes :
Le calcul de V-Attention s’effectue comme suit :
-
Projection avec mémoire contextuelle : Avec ,
Chaque variable reçoit un score intermédiaire d’importance historique borné entre et .
-
Projection des caractéristiques instantanées : Avec ,
Cette matrice capture les corrélations instantanées entre les variables.
-
Combinaison et normalisation : Le score conjoint des variables s’écrit :
Le facteur de normalisation adapte l’échelle au nombre de variables .
Les poids d’attention finaux par variable pour le TPIM s’obtiennent par softmax :
avec et .
Assemblage hiérarchique des prédictions
Pour répondre à l’objectif R2 (construire la décision globale à partir des prédictions élémentaires) tout en respectant R3 (préserver la pureté des caractéristiques locales), TAIL-MIL orchestre une double agrégation ascendante.
Étape 1 : Agrégation des VI-TPIM vers le TPIM
Pour chaque variable au pas de temps , une tête de classification calcule un score d’anomalie directement depuis l’embedding local non corrompu :
Ce score scalaire estime la probabilité intrinsèque que la cellule soit anormale. Les poids de V-Attention pondèrent ensuite ces estimations pour former la prédiction au niveau du pas de temps :
Étape 2 : Agrégation des TPIM vers le TAB
De façon symétrique, la prédiction globale pour l’ensemble du sac temporel (le TAB) est obtenue en pondérant les prédictions par les poids de T-Attention :
Le résultat constitue la prédiction finale de l’échantillon.
VI-TPIM (variables)  : ŷ_(i,j) = p_i(f(X_(i,j)))
      │
      ▼  (Pondération par V-Attention : m_(i,j))
TPIM (pas de temps)  : g_i(X_i) = Σ m_(i,j) ŷ_(i,j)
      │
      ▼  (Pondération par T-Attention : m_i)
TAB (séquence)       : g(X)     = Σ m_i g_i(X_i)
Grâce à cette formulation, un gradient calculé à partir de la fonction de perte appliquée sur se rétropropage à travers tous les niveaux hiérarchiques. Le modèle apprend ainsi à localiser les instants et les capteurs anormaux sans avoir jamais reçu d’annotations fines à ces échelles durant l’entraînement.
Vue d’ensemble de l’architecture
Le schéma suivant illustre l’interaction entre les flux d’attention contextuelle et les flux de prédictions locales indépendantes :
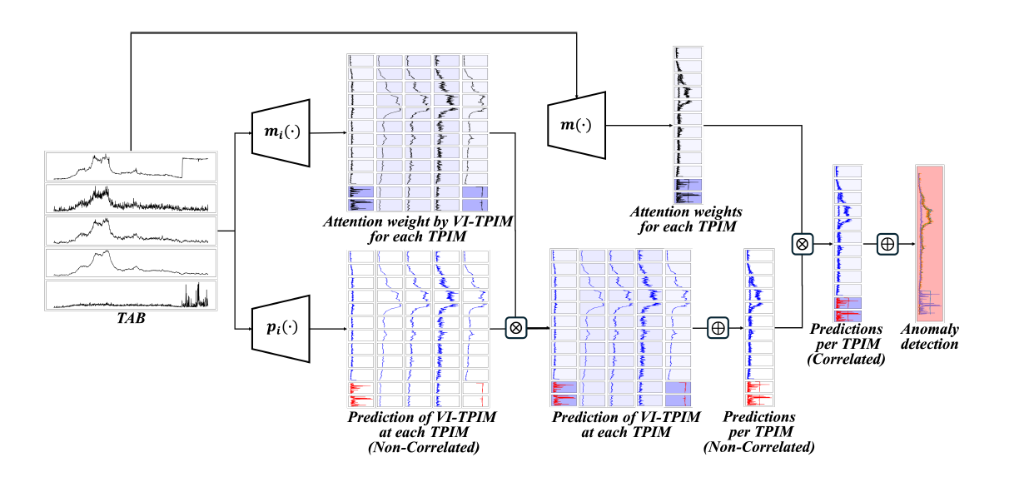 Figure 1 : Architecture générale de TAIL-MIL (reproduite d’après Jang & Kwon, AAAI 2025).
Conclusion
L’architecture TAIL-MIL apporte une réponse élégante et rigoureuse au défi de la détection et de la localisation d’anomalies multivariées sous supervision faible :
- Exploitation contextuelle ciblée : T-Attention et V-Attention capturent les interdépendances temporelles et inter-variables pour attribuer des poids d’attention pertinents.
- Supervision ascendante : La décision globale est une combinaison linéaire directe des prédictions locales, garantissant une interprétabilité native et une détection multi-échelle.
- Conservation de l’information locale : Les scores élémentaires sont calculés sur des représentations non déformées par le contexte lointain, évitant de noyer un signal anormal local dans du bruit environnant.
Référence
- J.~Jang et H.-Y.~Kwon, TAIL-MIL: Time-Aware and Instance-Learnable Multiple Instance Learning for Multivariate Time Series Anomaly Detection, Proceedings of the AAAI Conference on Artificial Intelligence, vol. 39, n° 17, p. 17582–17589, 2025.
Notes de la semaine
Chaque dimanche, je partage ce que j'ai appris : articles de recherche, idées, expériences et questions qui me sont restées en tête.
Vous pouvez vous désabonner à tout moment en un clic.
Discussion sur cet article0
Rejoindre la discussion
A secure sign-in link will be sent to your email address.
Chargement de la discussion...